
robots.txt是抓取控制文件,不是隐私保护工具,也不是保证页面不被索引的删除指令。GEO项目中需要同时考虑传统搜索爬虫、AI搜索爬虫、训练用途爬虫和用户触发抓取,但不能把所有User-agent混为一谈。企业应根据内容公开策略分别允许或限制,并保证Sitemap、公开页面和必要资源不会被误封。
技术原理
爬虫会按照User-agent匹配规则读取允许和禁止路径。不同平台可能提供独立机器人名称和用途说明,因此同一公司的搜索用途与模型训练用途也可能是两个控制项。Disallow阻止抓取内容,但外部链接仍可能让URL被发现;若需要阻止索引,通常要允许抓取后让爬虫读取noindex,或使用认证和访问控制。服务器防火墙、CDN规则与robots.txt也必须保持一致。
实施步骤
先列出公开内容、后台、安装目录、日志、搜索结果页、参数页和下载文件,定义哪些能抓取。robots.txt中保留最少且清晰的规则,使用绝对Sitemap地址,并针对已确认的机器人名称配置策略。不要复制来源不明的超长爬虫名单。发布前测试关键URL是否被目标规则允许,再检查CDN、WAF和速率限制是否拦截合法机器人。robots.txt变更应进入版本管理并记录修改人和日期。
验证与监测
监测服务器日志中的User-agent、访问路径、状态码和抓取频率。规则修改后,应观察目标爬虫是否停止或恢复访问,并检查Google Search Console等平台的抓取和索引报告。若大量合法请求返回403或429,要同时检查安全插件与CDN。对伪造User-agent的访问,不能仅凭名称信任,可结合官方IP验证方式。
常见错误
常见错误包括Disallow整个站点后忘记恢复、屏蔽CSS和JavaScript导致页面渲染异常、用robots.txt隐藏客户资料,以及在不同规则中互相覆盖。任何敏感数据都不应依赖robots.txt保护,因为该文件公开可见,真正的访问限制必须由身份认证和服务器权限完成。
落地建议
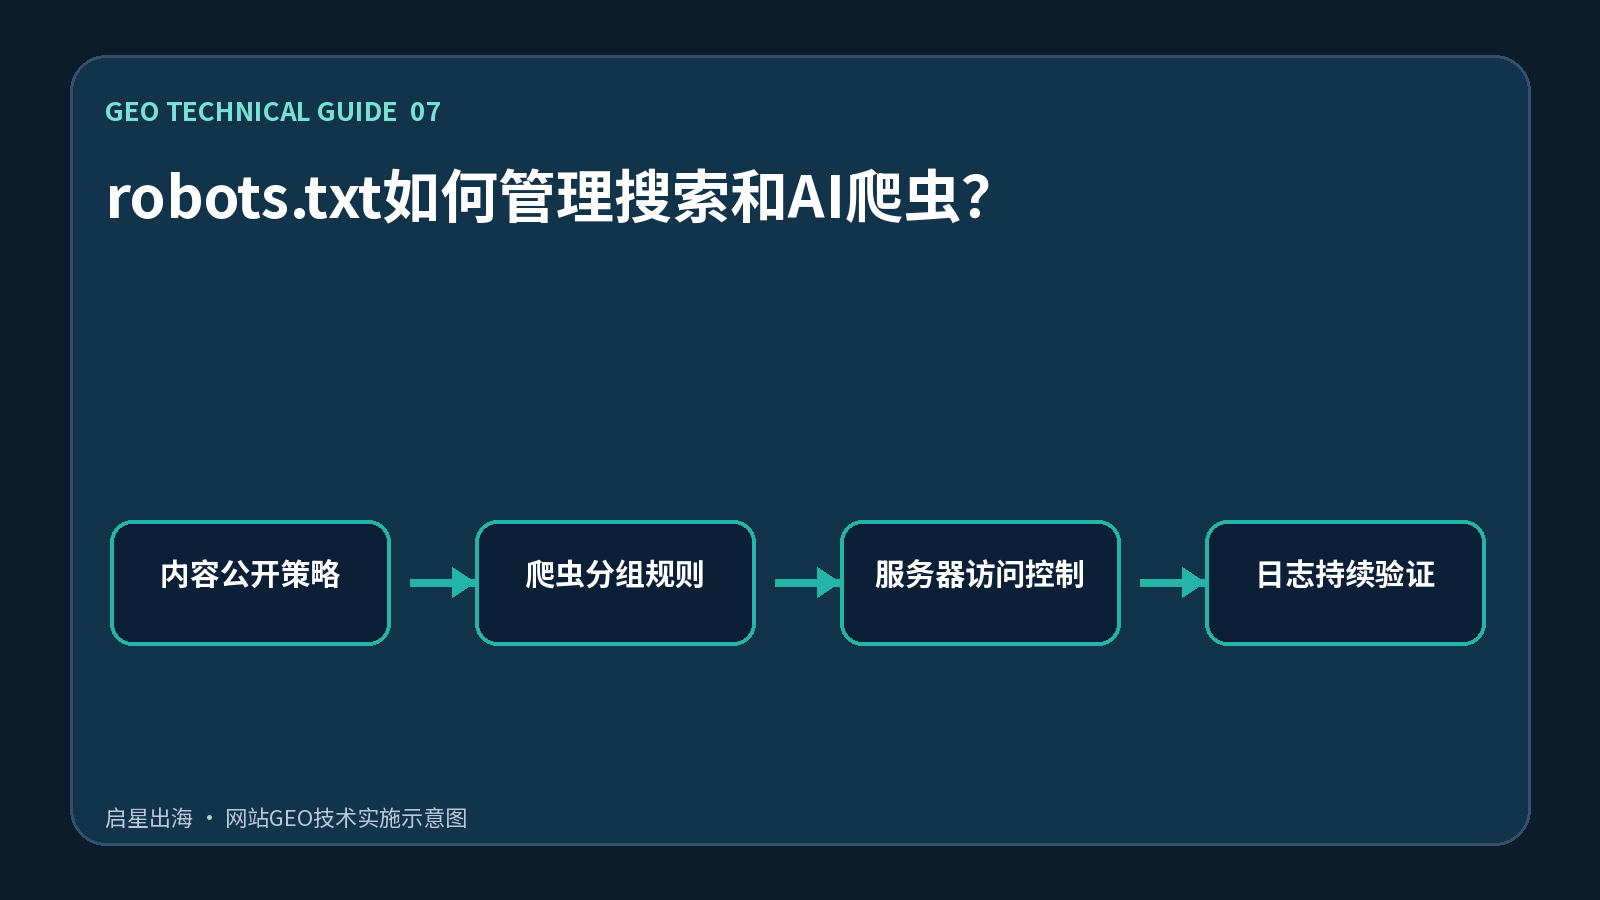
落地时应把“内容公开策略、爬虫分组规则、服务器访问控制、日志持续验证”写入同一份发布检查表,明确内容负责人、技术负责人和复核日期。任何改动都要同时检查页面可见内容、HTML源代码、结构化数据、内部链接和站点地图,避免前台已经更新而机器读取层仍保留旧值。GEO不是一次性安装插件,也不能保证任何平台一定引用;它是一套持续提高信息可抓取、可验证、可归因和可引用程度的内容与技术工程。