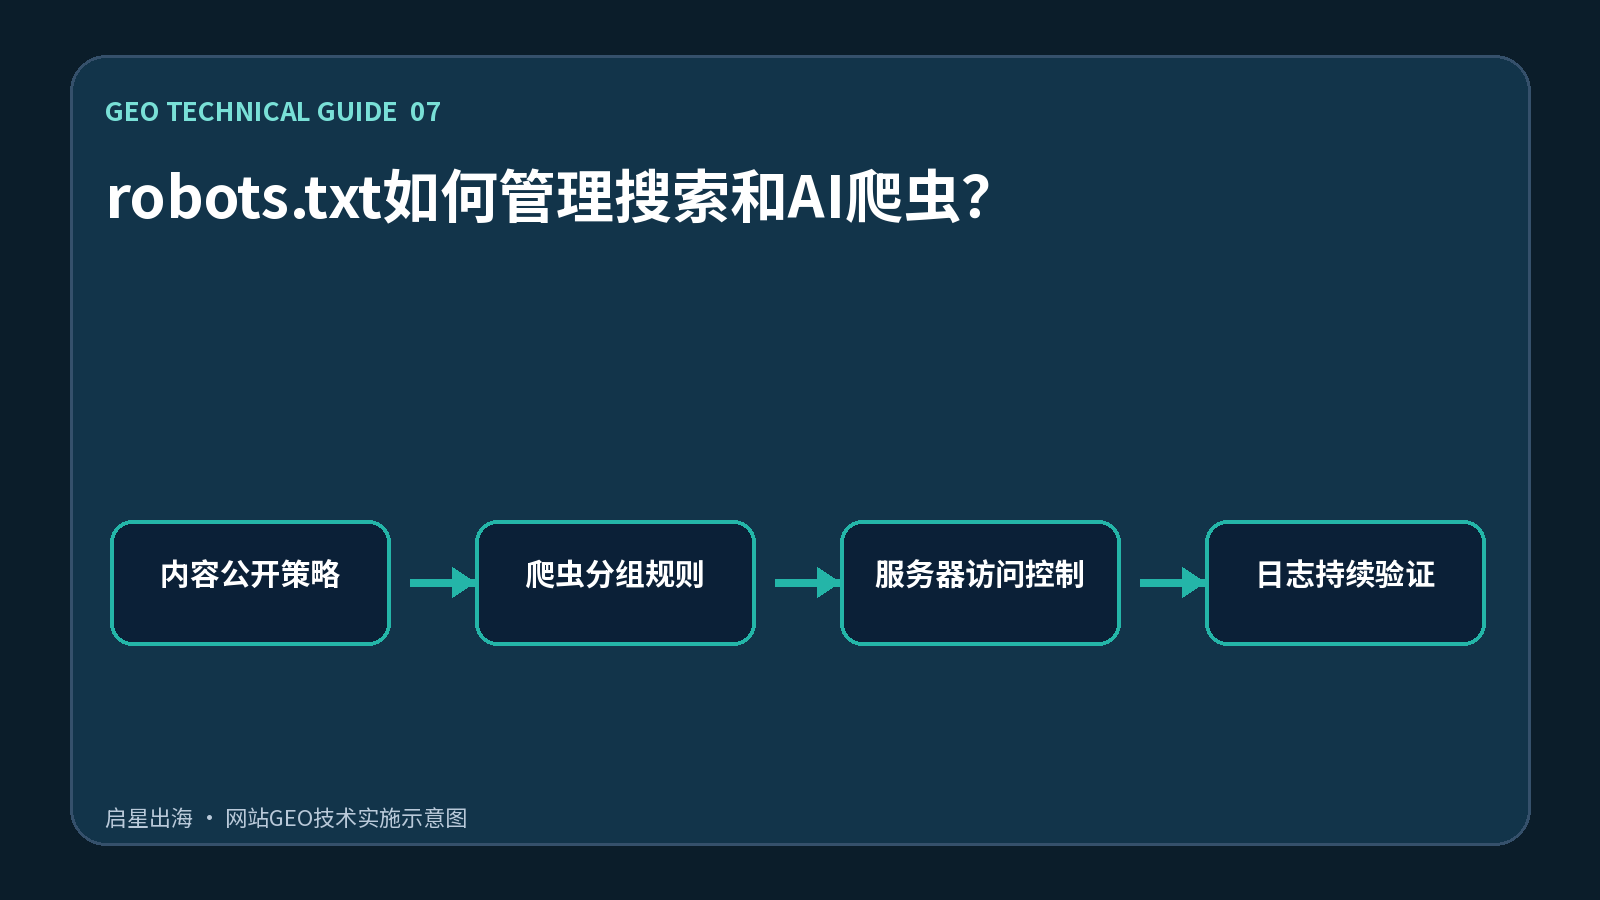
Robots.txt ist ein Tool zum Erfassen von Kontrolldateien, nicht zum Schutz der Privatsphäre, oder um sicherzustellen, dass Seiten nicht indexiert werden. Das GEO-Projekt muss sowohl traditionelle als auch vom Benutzer ausgelöste Reptilien, AIS-Reptilien, Trainingsreptilien und vom Benutzer ausgelöste Greifer berücksichtigen, kann jedoch nicht mit allen Benutzeragenten verwechselt werden. Unternehmen sollten sich gemäß ihrer Content-Public-Strategie gegenseitig erlauben oder einschränken und sicherstellen, dass Sitemap, die öffentliche Seite und die notwendigen Ressourcen nicht verfehlt werden.
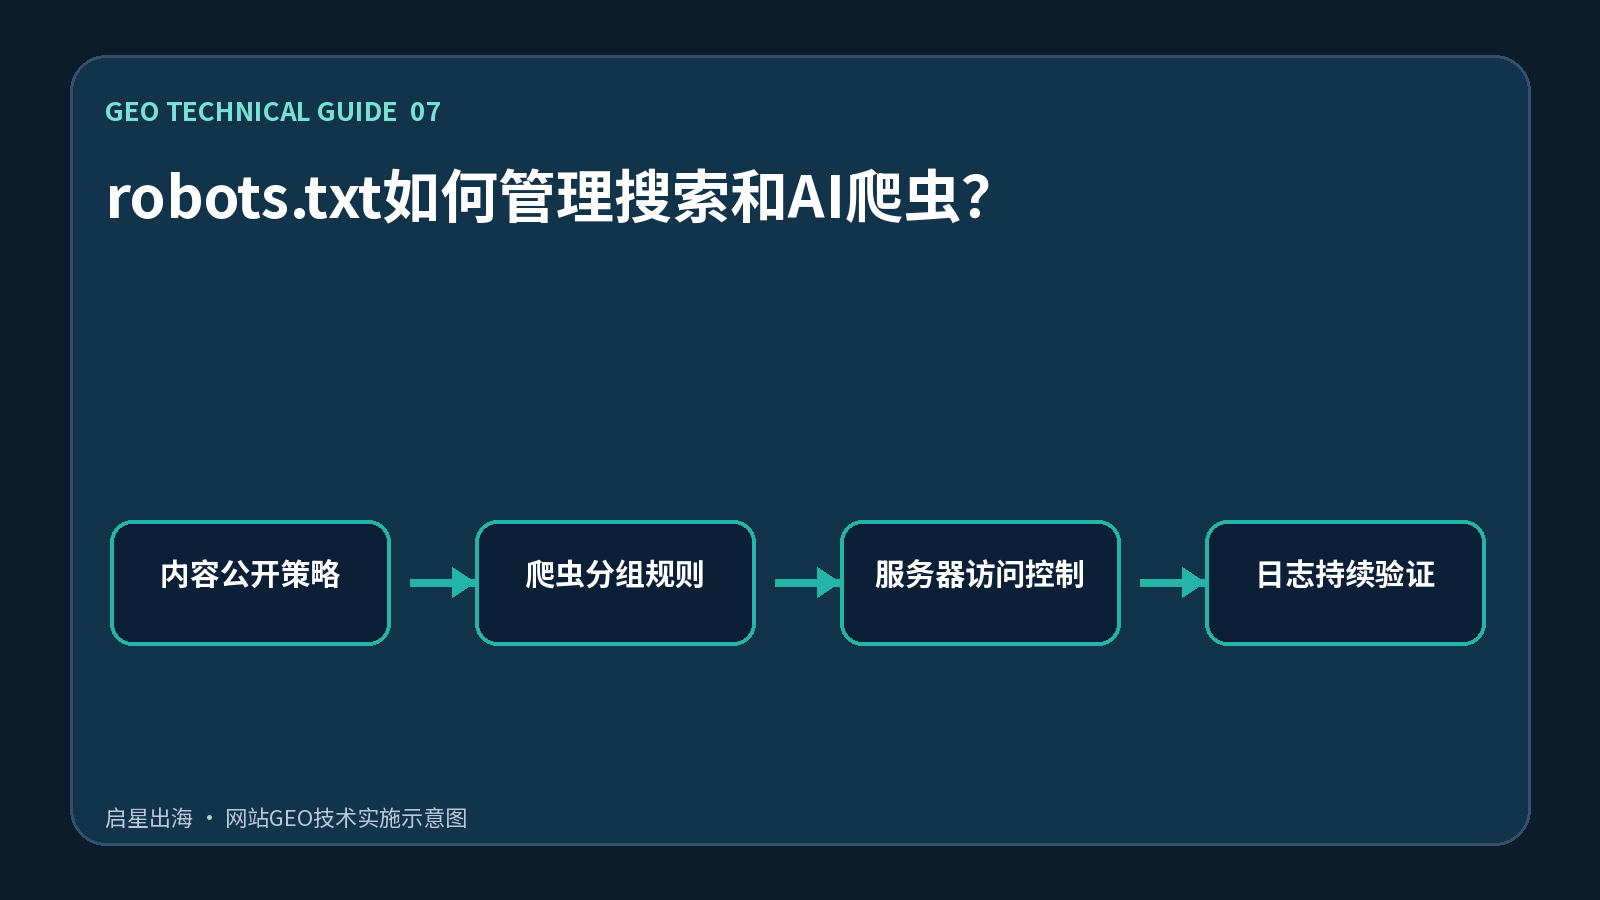
Die Reptilien lesen erlaubte und verbotene Pfade in Übereinstimmung mit den Regeln zum Abgleich von Benutzer-Agenten. Verschiedene Plattformen können unabhängige Roboternamen und Beschreibungen von Verwendungen bereitstellen, so dass Suchanwendungen und Modellschulungen für dasselbe Unternehmen auch zwei Kontrollelemente sein können. Disallow verhindert die Erfassung von Inhalten, aber externe Links können immer noch zur Entdeckung von URLs führen; Wenn ein Index zum Stoppen benötigt wird, ist es normalerweise erlaubt, Noindex zu lesen oder Authentifizierungs- und Zugriffskontrollen zu verwenden.
Listet öffentliche Inhalte, Backstage, Installationsverzeichnisse, Protokolle, Suchergebnisseiten, Parameterseiten und Download-Dateien auf und definiert, welche abgerufen werden können. Robots.txt behält die am wenigsten klaren und klaren Regeln bei, verwendet absolute Sitemap-Adressen und Adressen für identifizierte Roboternamenskonfigurationen. Testen Sie, ob wichtige URLs nach den Zielregeln zulässig sind, und prüfen Sie, ob CDNs, WAFs und Geschwindigkeitsbegrenzungen legitime Roboter abfangen.
Überwacht den Zugriffspfad, den Statuscode und die Zugriffshäufigkeit im Serverprotokoll. Die Regeln sollten geändert werden, um zu beobachten, ob das Zielreptil den Zugriff gestoppt oder wieder aufgenommen hat, und um die Erfassungs- und Indexberichte von Plattformen wie der Google Seach Console zu überprüfen.
Häufige Fehler sind die Tatsache, dass die gesamte Website von Disallow vergessen hat, sich zu erholen, die Blockierung von CSS und JavaScript hat dazu geführt, dass Anomalien auf Seiten dargestellt wurden, die Verwendung von robots.txt, um Kundeninformationen zu verbergen und sich gegenseitig in verschiedenen Regeln zu überwältigen. Keine sensiblen Daten sollten sich zum Schutz auf robots.txt verlassen, da das Dokument öffentlich sichtbar ist und echte Zugriffsbeschränkungen durch Authentifizierung und Serverprivilegien erfüllt werden müssen.
Wenn Sie auf dem Boden landen, müssen Sie die gleiche Release-Checkliste für die Strategie zur Offenlegung von Inhalten, die Regeln für die Gruppierung von Reptilien, die Serverzugriffskontrollen, die fortlaufende Validierung des Logbuchs, die Identifizierung des Inhaltsmanagers, des technischen Offiziers und des Datums angeben Jede Änderung muss mit einer Überprüfung des sichtbaren Inhalts der Seite, des HTML-Quellcodes, strukturierter Daten, interner Links und Site-Maps einhergehen, um zu vermeiden, dass die Rezeption aktualisiert wurde und die Ebenen für das maschinelle Lesen noch alte Werte haben. GEO ist kein einmaliges Plugin und garantiert nicht, dass eine Plattform zitiert wird; es ist eine Reihe von Inhalten und technischen Arbeiten, die die Zugänglichkeit, Validierung, Zuordnung und Zitierung von Informationen kontinuierlich verbessern.