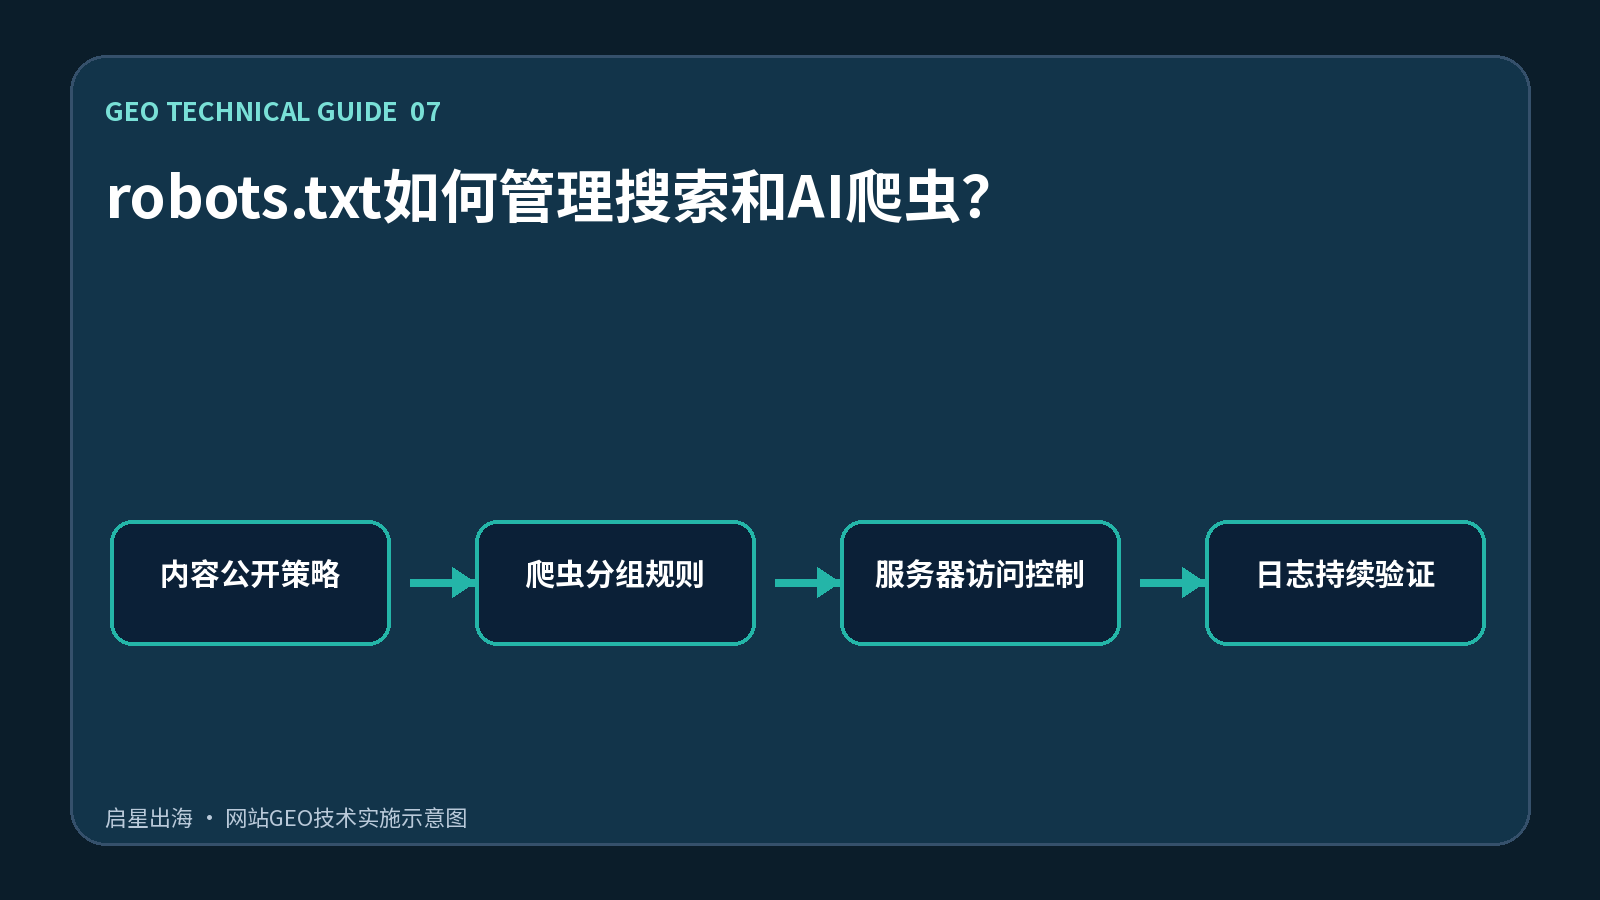
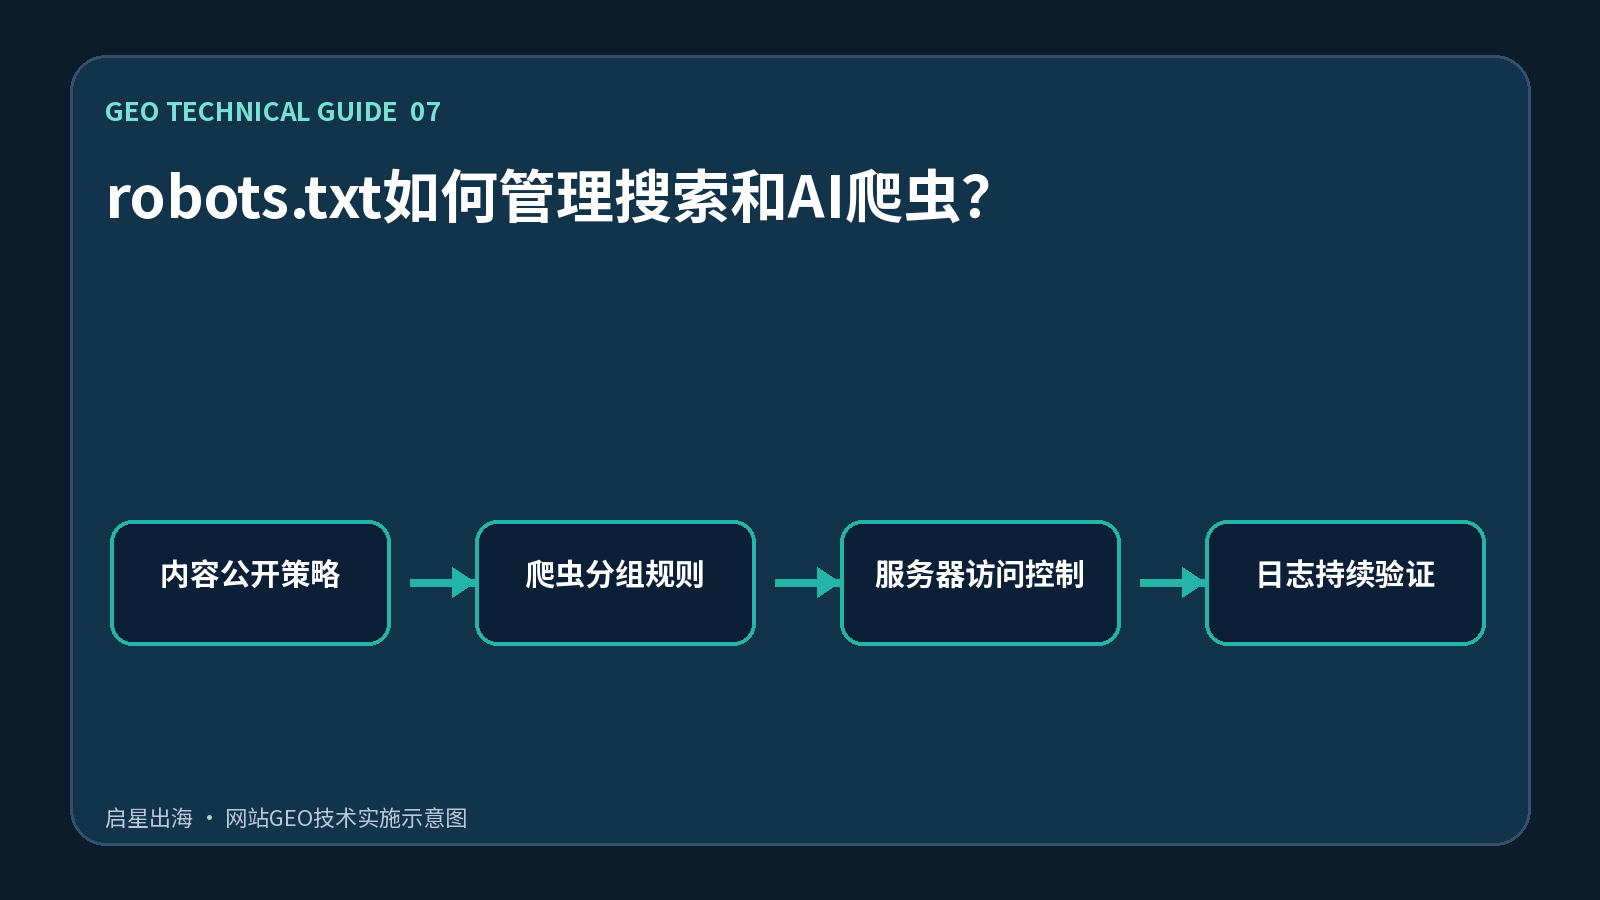
Robots.txt est un outil pour capturer les fichiers de contrôle, et non la protection de la vie privée, ou pour s'assurer que les pages ne sont pas indexées. Le projet GEO doit tenir compte à la fois des reptiles traditionnels et des reptiles déclenchés par l'utilisateur, des reptiles AIS, des reptiles de formation et des captures déclenchées par l'utilisateur, mais il ne peut être confondu avec tous les agents utilisateurs. Les entreprises devraient s'autoriser ou se limiter selon leur stratégie de contenu-public, et veiller à ce que Plan du site, la page publique et les ressources nécessaires ne manquent pas.
Les reptiles liront les chemins autorisés et interdits conformément aux règles d'appariement utilisateur-agent. Différentes plateformes peuvent fournir des noms robotiques indépendants et des descriptions d'utilisation, de sorte que les applications de recherche et la formation de modèles pour une même entreprise peuvent également être deux éléments de contrôle. L'interdiction empêche la capture de contenu, mais les liens externes peuvent encore conduire à la découverte d'URL; si un index est nécessaire pour s'arrêter, il est généralement autorisé à lire noindex, ou à utiliser des contrôles d'authentification et d'accès.
Liste le contenu public, backstage, répertoires d'installation, journaux, pages de résultats de recherche, pages de paramètres et fichiers de téléchargement, et définit ce qui peut être récupéré. Robots.txt maintient les règles les moins claires et les moins claires, utilise des adresses Plan du site et des adresses absolues pour les configurations de noms de robots identifiés. Testez si les URL clés sont autorisées par les règles de la cible, puis vérifiez si les CDN, les WAF et les limites de vitesse interceptent les robots légitimes.
Surveille le chemin d'accès, le code d'état et la fréquence d'accès dans le journal du serveur. Les règles devraient être modifiées pour vérifier si le reptile cible a cessé ou repris l'accès et pour vérifier les rapports de capture et d'index des plateformes telles que Google Seach Console.
Les erreurs courantes comprennent le fait que l'ensemble du site de Disallow a oublié de récupérer, le blocage de CSS et JavaScript a conduit à des anomalies de rendu de page, l'utilisation de robots.txt pour cacher des informations client et de se submerger dans différentes règles. Aucune donnée sensible ne devrait dépendre de robots.txt pour la protection, car le document est visible publiquement et les véritables restrictions d'accès doivent être remplies par les privilèges d'authentification et de serveur.
Lorsque vous atterrissez sur le terrain, vous devrez inclure la même liste de contrôle de diffusion pour la stratégie de divulgation du contenu, les règles de regroupement des reptiles, les contrôles d'accès au serveur, la validation continue du journal de bord, l'identification du gestionnaire de contenu, de l'agent technique et la date de Toute modification doit être accompagnée d'un examen du contenu visible de la page, du code source HTML, des données structurées, des liens internes et des cartes du site, afin d'éviter que la réception ait été mise à jour et que les couches de lecture automatique aient encore des valeurs anciennes. GEO n'est pas un plugin unique, et ne garantit pas qu'une plate-forme sera citée ; c'est un ensemble de contenus et de travaux techniques qui améliore continuellement l'accessibilité, la validation, l'attribution et la citation des informations.