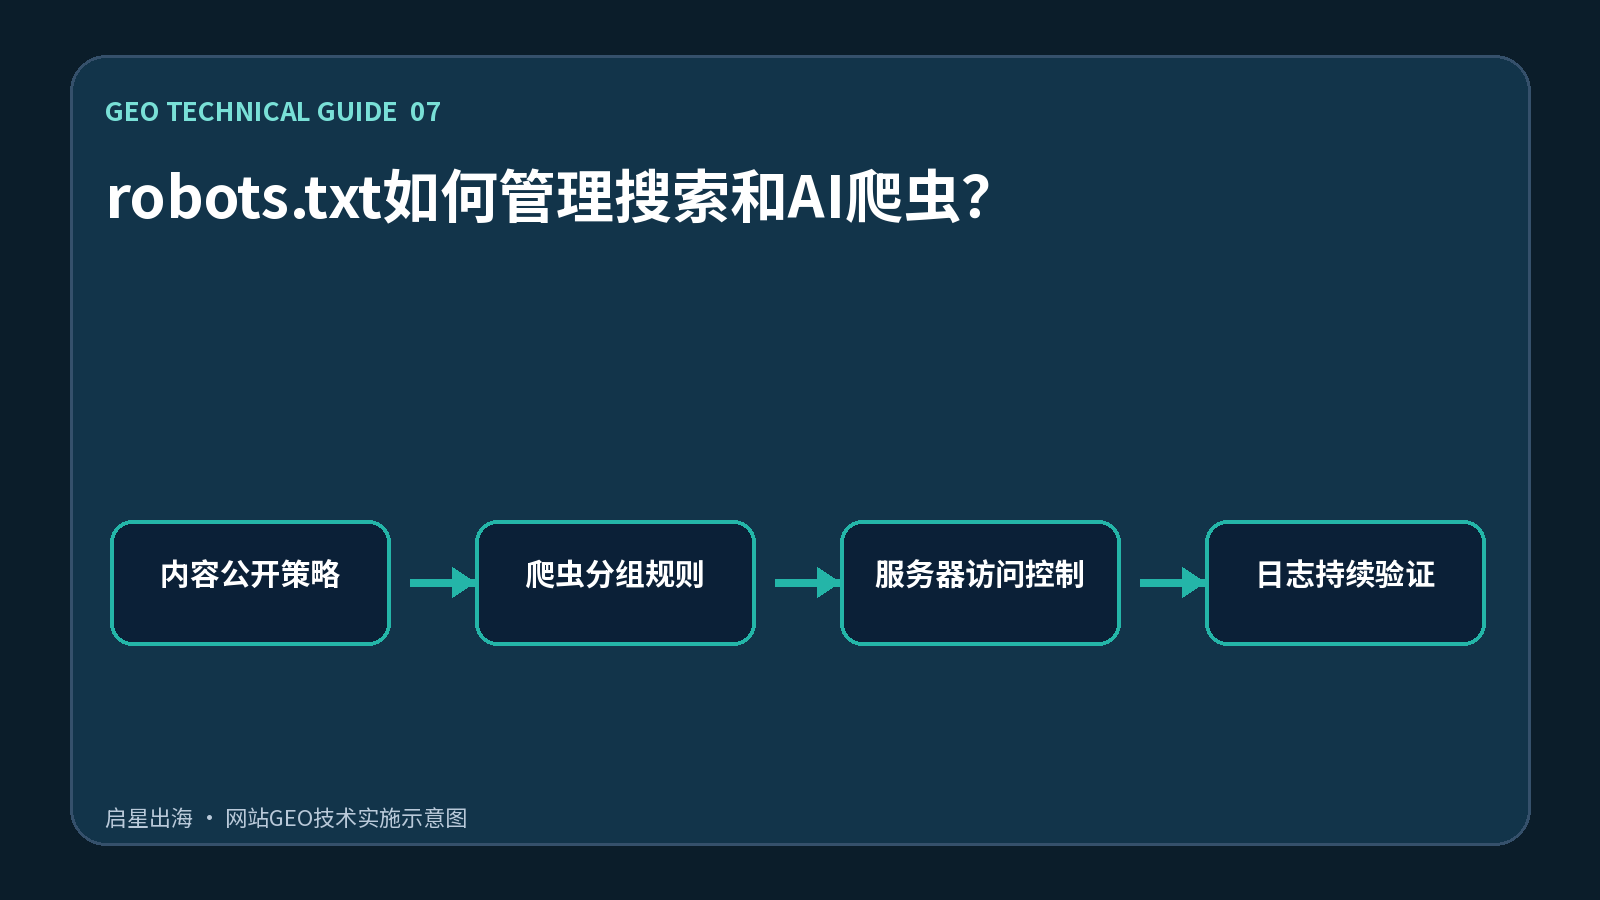
Robots.txt es una herramienta para capturar archivos de control, no protección de privacidad, o para asegurar que las páginas no sean indexadas. El proyecto GEO tiene que considerar reptiles tradicionales y activados por el usuario, reptiles de AIS, reptiles de entrenamiento y tomas activadas por el usuario, pero no puede confundirse con todos los usuarios-agentes. Las empresas deben permitirse o limitarse mutuamente de acuerdo con su estrategia de contenido-público, y asegurarse de que el sitio web, la página pública y los recursos necesarios no sean mal sellados.
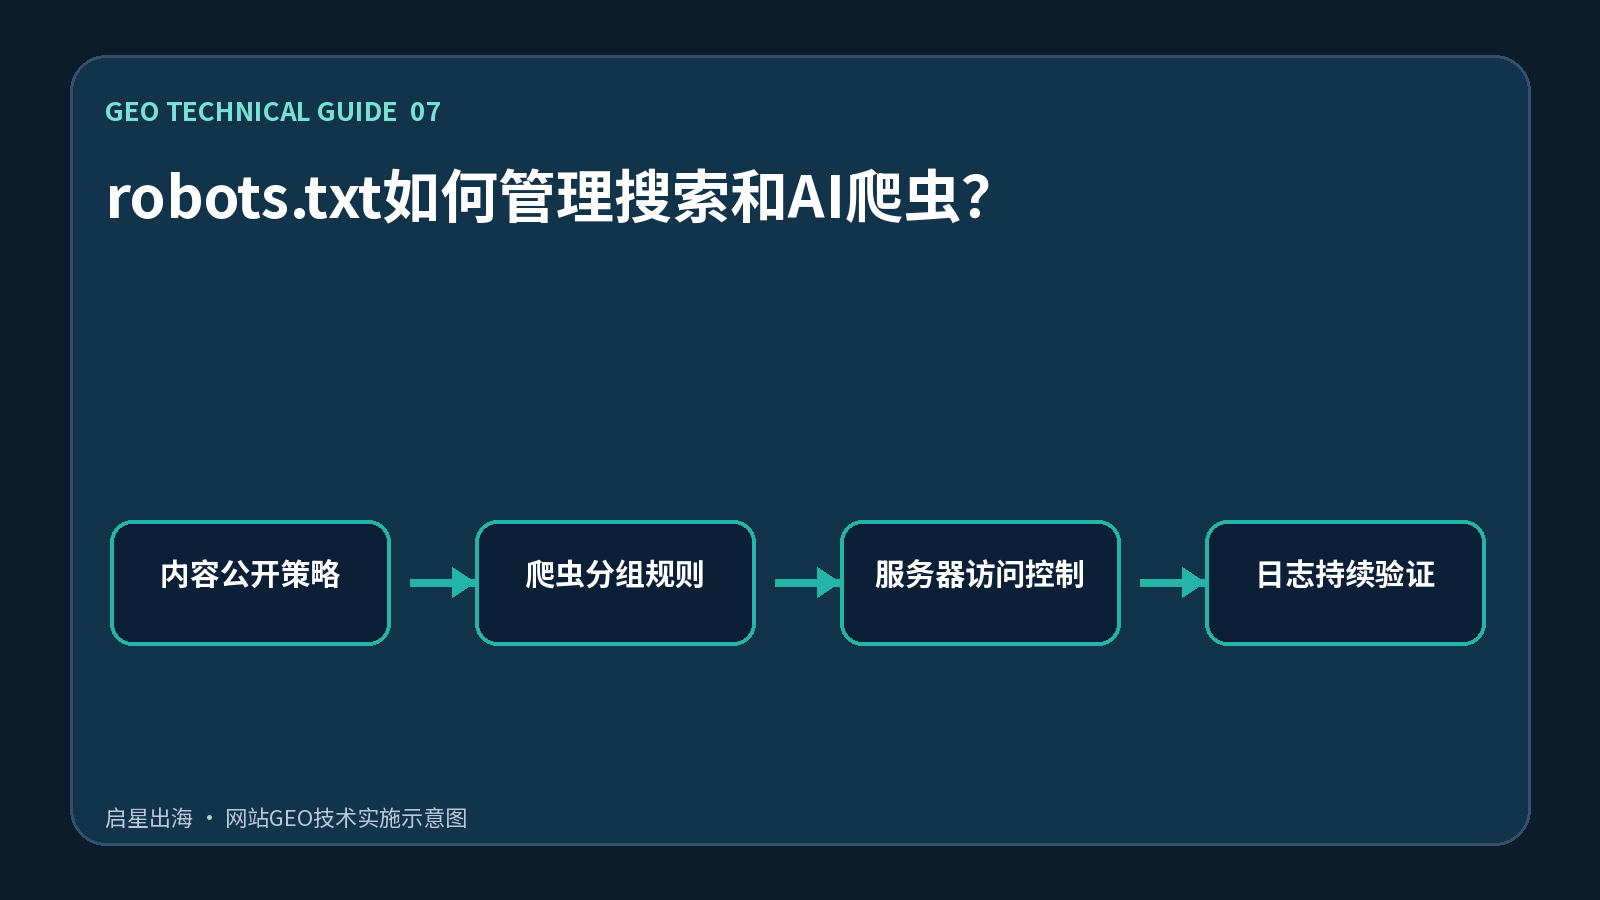
Los reptiles leerán caminos permitidos y prohibidos de acuerdo con las reglas de juego del Usuario-agente. Diferentes plataformas pueden proporcionar nombres robóticos independientes y descripciones de usos, por lo que las aplicaciones de búsqueda y formación de modelos para la misma empresa también pueden ser dos elementos de control. Disallow evita la captura de contenido, pero los enlaces externos pueden conducir al descubrimiento de URLs; si se necesita un índice para detenerse, generalmente se permite leer noindex, o utilizar controles de autenticación y acceso.
Lista contenido público, backstage, directorios de instalación, registros, páginas de resultados de búsqueda, páginas de parámetros y archivos de descarga, y define qué se puede recuperar. Robots.txt mantiene las reglas menos claras y claras, utiliza direcciones y direcciones del mapa absolutos para las configuraciones de nombres de robot identificadas. No copie la lista de reptiles de ultralong de fuentes desconocidas. Pruebe si las URL clave están permitidas por las reglas de destino, a continuación, compruebe si los CDN, WAFs y los límites de velocidad interceptan robots legítimos. Los cambios Robots.txt deben introducir cambios de gestión de versiones y registrar cambios.
Supervisa la ruta de acceso, código de estado y frecuencia de acceso en el registro del servidor. Las reglas deben ser modificadas para observar si el reptil objetivo ha detenido o reanudado el acceso y comprobar los informes de captura e índice de plataformas como Google Seach Console.
Los errores comunes incluyen el hecho de que todo el sitio de Disallow ha olvidado recuperarse, el bloqueo de CSS y JavaScript ha llevado a la página rendering anomalies, el uso de robots.txt para ocultar la información del cliente y abrumarse entre sí en diferentes reglas. Ningún dato sensible debe depender de robots.txt para la protección, porque el documento es visible públicamente y las verdaderas restricciones de acceso deben cumplirse mediante la autenticación y privilegios del servidor.
Cuando aterrices sobre el terreno, tendrás que incluir la misma lista de verificación para la estrategia de divulgación de contenidos, reglas de agrupación de reptiles, controles de acceso al servidor, validación continua de logbook, identificando al gestor de contenido, oficial técnico y fecha de Cualquier cambio debe ir acompañado de una revisión del contenido visible de la página, código fuente HTML, datos estructurados, enlaces internos y mapas del sitio, para evitar que la recepción haya sido actualizada y las capas de lectura de máquinas todavía tienen valores antiguos. GEO no es un plugin de una sola vez, y no garantiza que cualquier plataforma será citada; es un conjunto de contenidos y obras técnicas que mejora continuamente la accesibilidad, validación, atribución y cita de información.