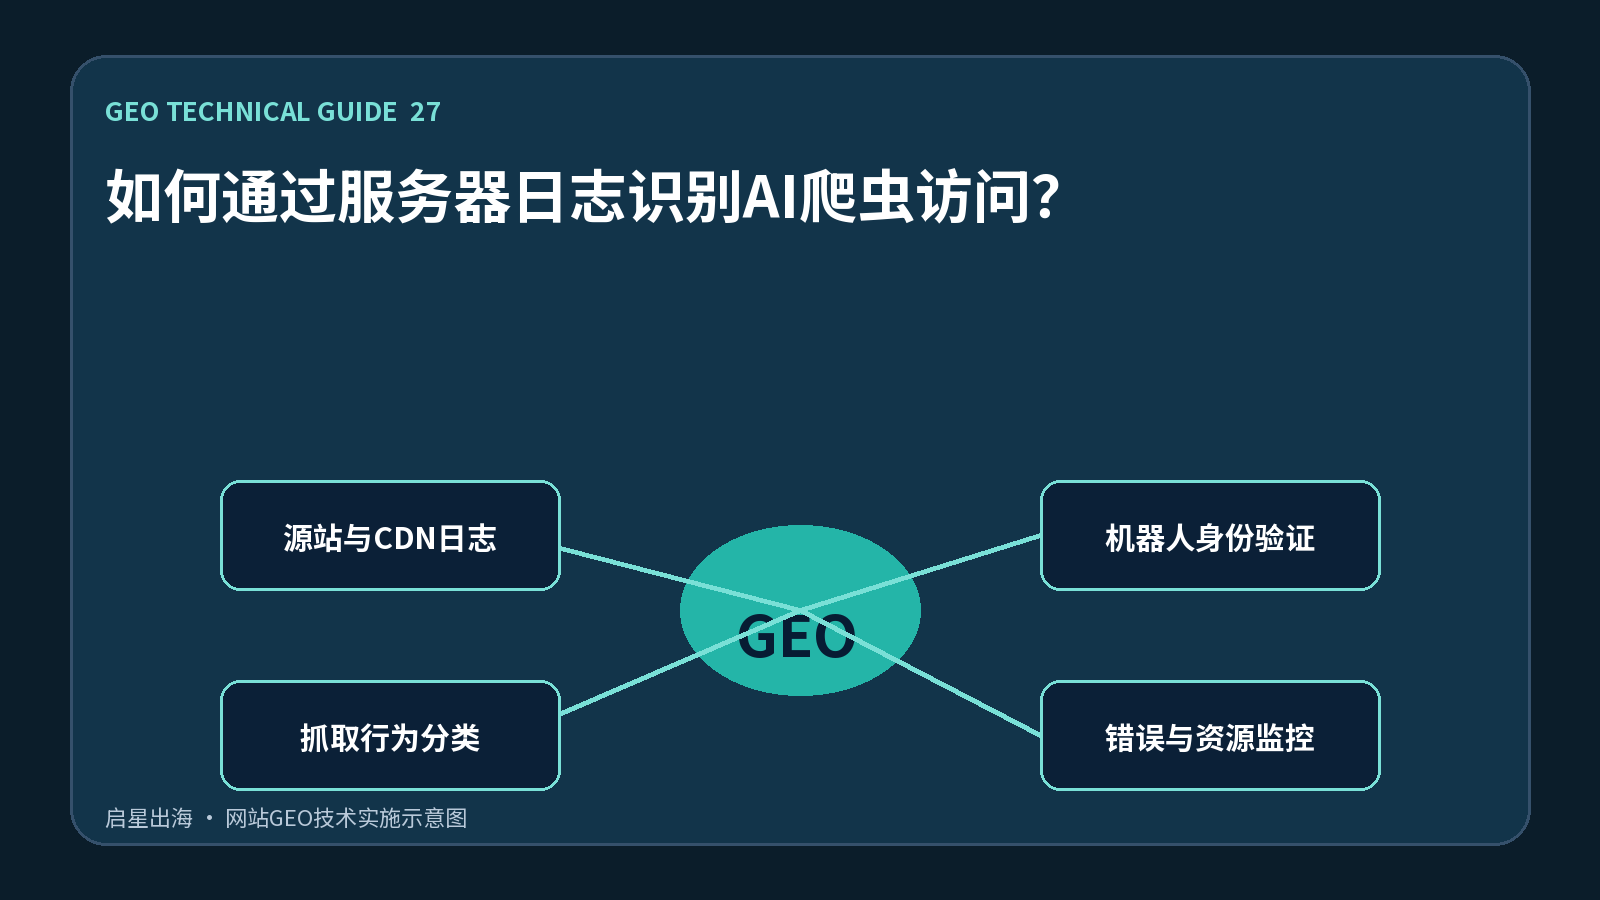
Seule l'installation d'un code statistique ne permet pas de voir le reptile dans son intégralité, car les robots n'exécutent généralement pas le JavaScript front-end. L'heure des requêtes de journal d'accès au serveur, l'IP, l'agent utilisateur, l'URL, le code d'état et la taille de la réponse sont la base pour juger si les robots de recherche et d'IA ont accès au site Web. L'analyse des journaux ne peut pas seulement rechercher des noms, car l'agent utilisateur peut forger, mais doit aussi être combiné avec l'authentification officielle et le comportement d'accès.
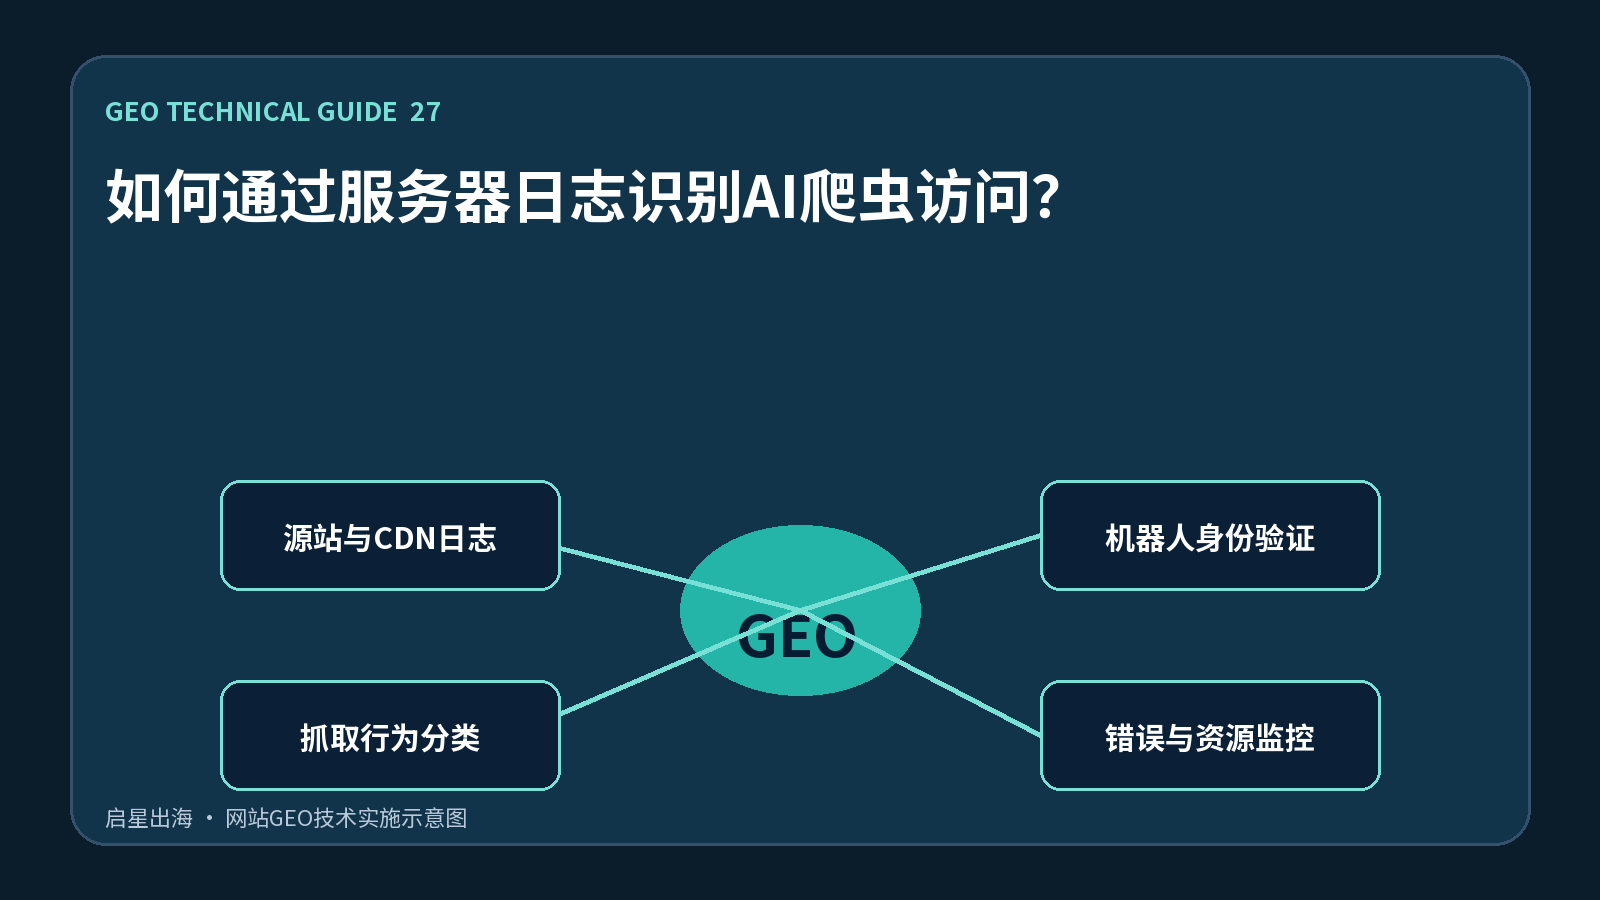
Une requête dans un journal ne correspond pas à un contenu indexé ou cité, mais montre si la saisie a eu lieu, quelles pages ont été visitées, arrêtée par 403 ou 429, et si les reptiles ont été capturés dans un cycle de paramètres. La vraie reconnaissance robotique peut être faite à l'aide de la plage IP officiellement publiée ou inversement et du processus de validation DNS. Le journal CDN, le journal source et le journal d'application devraient avoir le même temps et l'ID demandé pour localiser où l'interception s'est produite.
Définit le cycle de conservation du journal et les règles de désensibilisation de la vie privée, puis crée une mission de résolution, classifiant les reptiles de recherche connus, les reptiles de recherche AI, les reptiles d'entraînement et les robots ordinaires. Enregistre l'utilisateur-agent original, valide les résultats, le type d'URL, le code d'état, le temps de réponse et le cache. Crée des tableaux de bord pour voir les prises quotidiennes, les chemins de porte chauds, les taux d'erreur et les nouveaux robots. Définit les règles pour les backstages, les paramètres de recherche et les pauses de page illimitées pour empêcher les robots de consommer des ressources.
La surveillance porte sur le taux de capture effectif de la page centrale publique, le code de statut anormal, le ratio de récupération, le temps écoulé entre la mise à jour et la visite de retour et la distribution de la robotique.
Une erreur courante est que toutes les requêtes contenant du bot sont considérées comme crédibles, en lecture seule GA4, garder la PI complète indéfiniment, ignorer les exigences de confidentialité, ou traiter l'accès reptile comme un effet GEO. Les journaux peuvent seulement prouver l'accès, et en fin de compte doivent encore combiner les données d'indexation, de citation, de flux et de conversion.
Lorsque vous atterrissez, les stations source et les registres CDN, l'identification robotique, la classification du comportement de capture, l'erreur et la surveillance des ressources. la technologie et la date de l'examen. Tout changement doit être accompagné d'un examen du contenu visible de la page, du code source HTML, des données structurées, des liens internes et des cartes du site pour éviter que la réception ait été mise à jour et que la couche de lecture automatique conserve les anciennes valeurs. GEO n'est pas un plugin d'installation unique et ne garantit pas qu'une plate-forme sera citée; il s'agit d'un ensemble de contenus et de projets techniques qui améliorent continuellement l'accessibilité, la validation, l'attribution et la citation des informations.