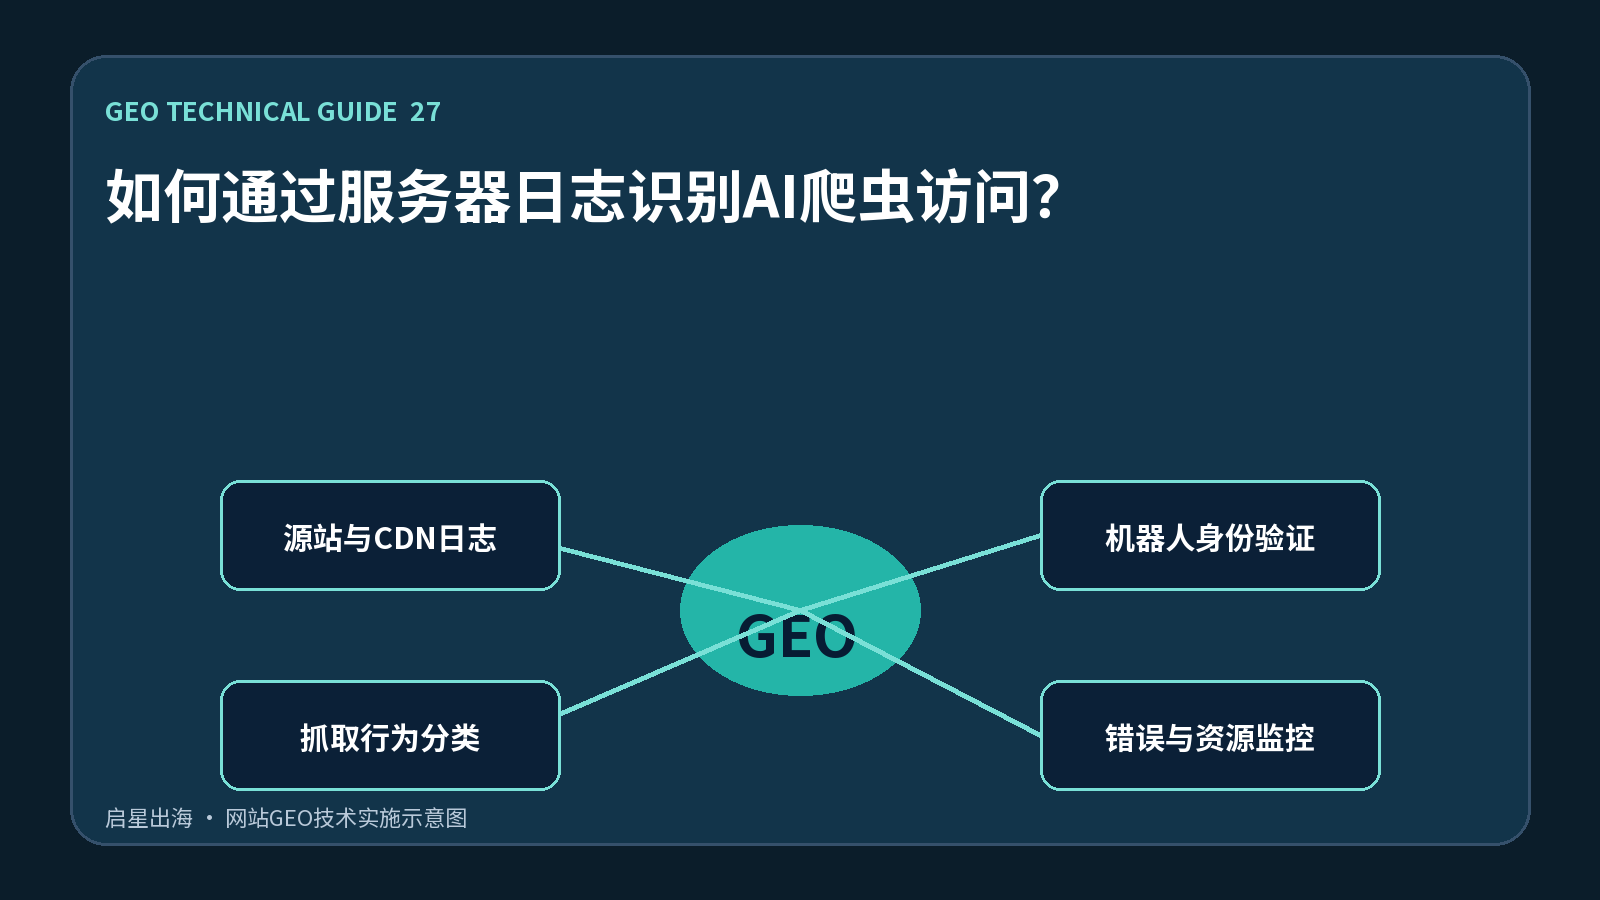
Sólo la instalación de un código estadístico no permite que el reptil sea visto en su totalidad, ya que los robots generalmente no realizan el JavaScript frontal. El tiempo de solicitud de registro de acceso al servidor, IP, agente de usuario, URL, código de estado y tamaño de respuesta son la base para juzgar si los robots de búsqueda y AI tienen acceso al sitio web. El análisis de registros no puede buscar nombres, porque el agente de usuario puede forjar, sino que también debe combinarse con la autenticación oficial y el comportamiento de acceso.
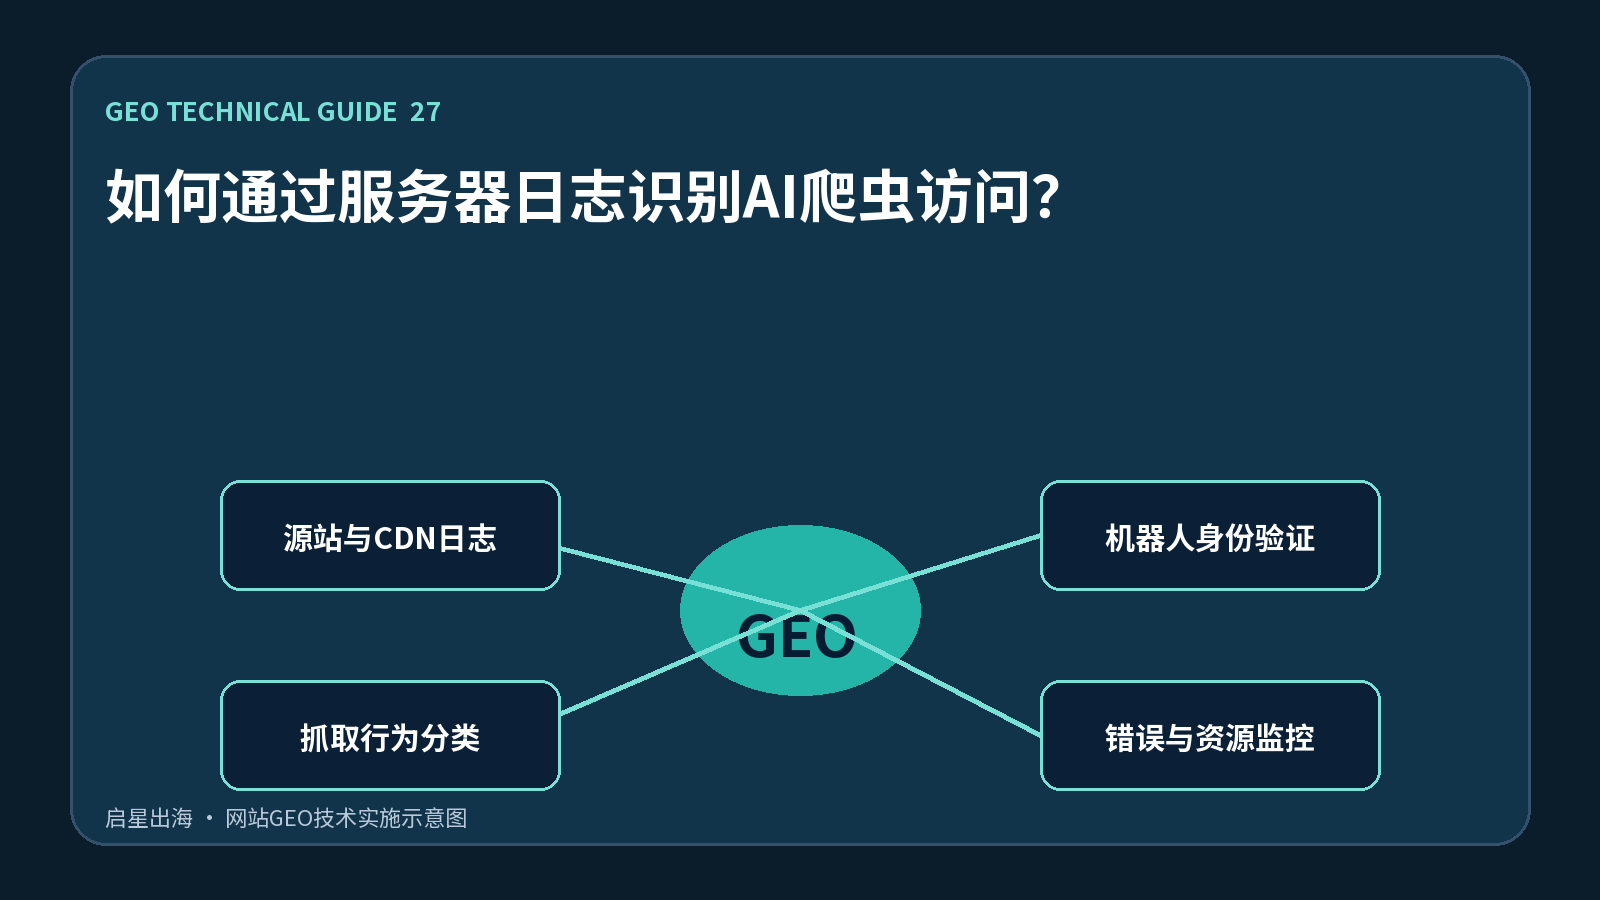
Una solicitud en un registro no equivale a un contenido indexado o citado, pero muestra si el agarre ocurrió, qué páginas fueron visitadas, detenidas en 403 o 429, y si los reptiles fueron atrapados en un ciclo del parámetro. El reconocimiento robótico real se puede hacer utilizando el rango IP oficial o el reverso y el proceso de validación DNS. El registro CDN, el registro fuente y el registro de aplicaciones deben tener el mismo tiempo y el ID solicitado para localizar donde ocurrió la interceptación.
Define el ciclo de retención de registros y las reglas de desensibilización de la privacidad, luego crea una misión de resolución, clasificando reptiles de búsqueda conocidos, reptiles de búsqueda de inteligencia artificial, reptiles de entrenamiento y robots comunes. Guarda el agente de usuario original, valida los resultados, tipo URL, código de estado, tiempo de respuesta y caché. Crea paneles para ver capturas diarias, rutas de puerta caliente, tasas de error y nuevos robots. Establece reglas para backstage, parámetros de búsqueda y rupturas de páginas ilimitadas para evitar que los robots consumen recursos.
El monitoreo se centra en la tasa de captura efectiva de la página principal pública, el código de estado anormal, la relación de recuperación, el tiempo de actualización a la visita de regreso, y la distribución de la robótica.
Un error común es que todas las solicitudes que contienen bot se consideran creíbles, leen solamente GA4, mantengan la IP completa indefinidamente, ignoren los requisitos de privacidad o traten el acceso reptil como un efecto GEO. Los registros sólo pueden probar el acceso, y en última instancia aún necesitan combinar datos de indexación, citación, flujo y conversión.
Cuando aterrices, las “sillas de recursos y los registros de CDN, la identificación robótica, la clasificación de comportamientos de captura, el error y el monitoreo de recursos” deben incluirse en la misma lista de verificación de liberación, especificando quién es responsable del contenido, quién es responsable de la y la fecha del examen. Cualquier cambio debe ir acompañado de una revisión del contenido visible de la página, código fuente HTML, datos estructurados, enlaces internos y mapas del sitio para evitar que la recepción se ha actualizado y la capa de lectura de la máquina conserva los valores antiguos. GEO no es un plugin de instalación de una sola vez y no garantiza que ninguna plataforma sea citada; es un conjunto de contenidos y proyectos técnicos que mejora continuamente la accesibilidad, validación, atribución y cita de información.