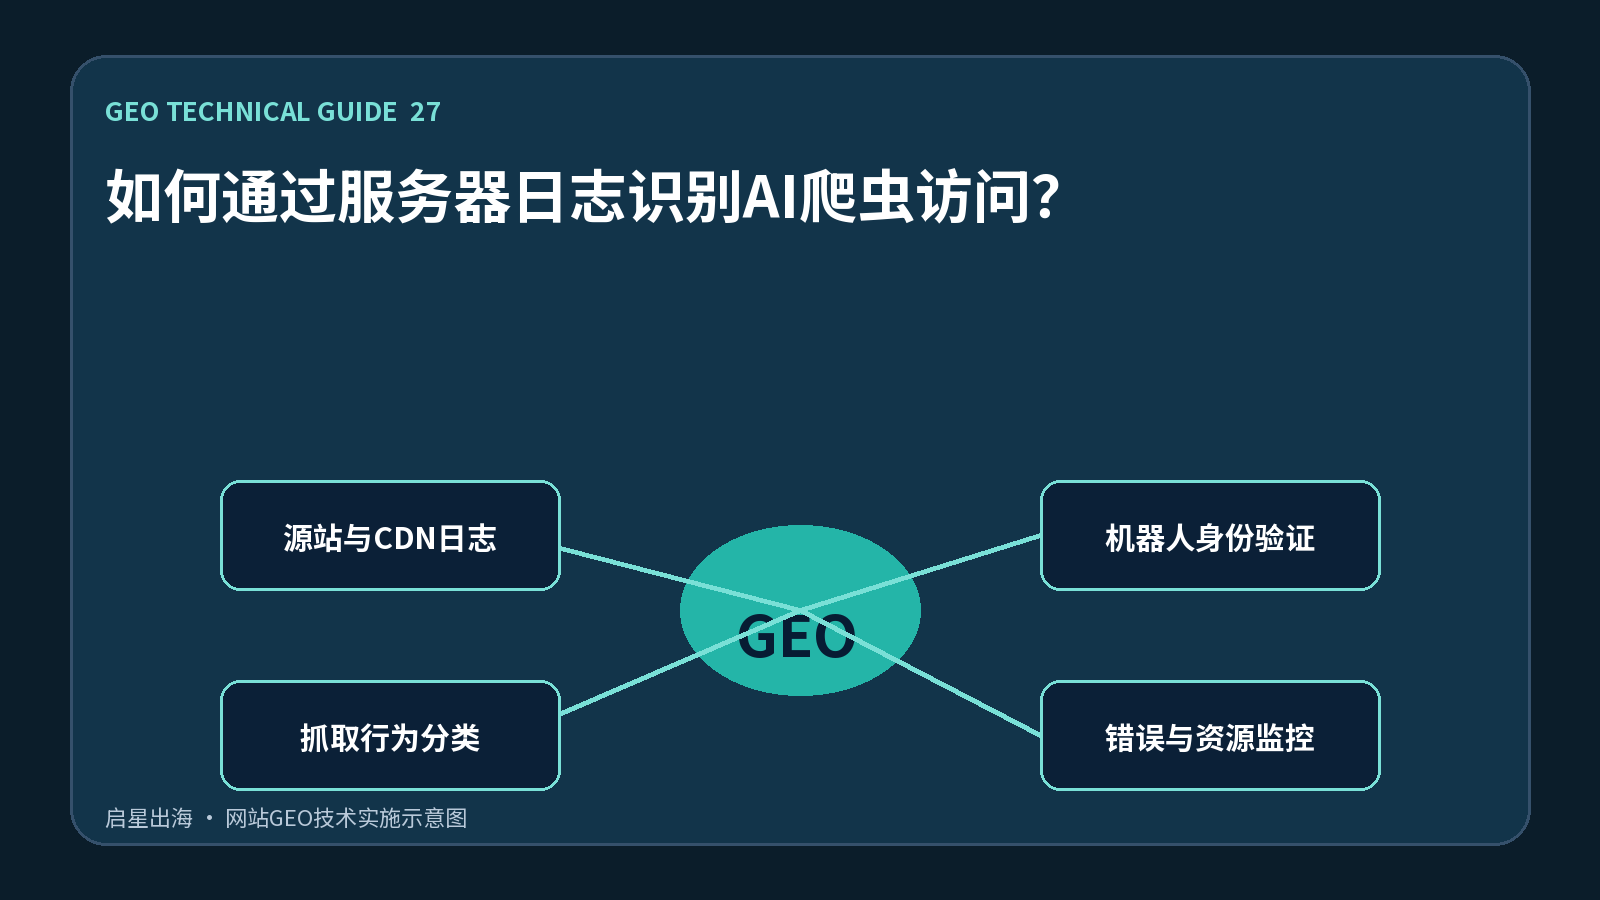
Nur die Installation eines statistischen Codes erlaubt es nicht, das Reptil in seiner Gesamtheit zu sehen, da Roboter normalerweise nicht das Front-End-Javascript ausführen. Server Access Log Log Requests Zeit, IP, User-Agent, URL, Statuscode und Antwortgröße sind die Grundlage für die Beurteilung, ob Such- und KI-Roboter Zugriff auf die Website haben. Die Log-Analyse kann nicht nur nach Namen suchen, da User-Agent schmieden kann, sondern auch mit offizieller Authentifizierung und Zugriffsverhalten kombiniert werden muss.
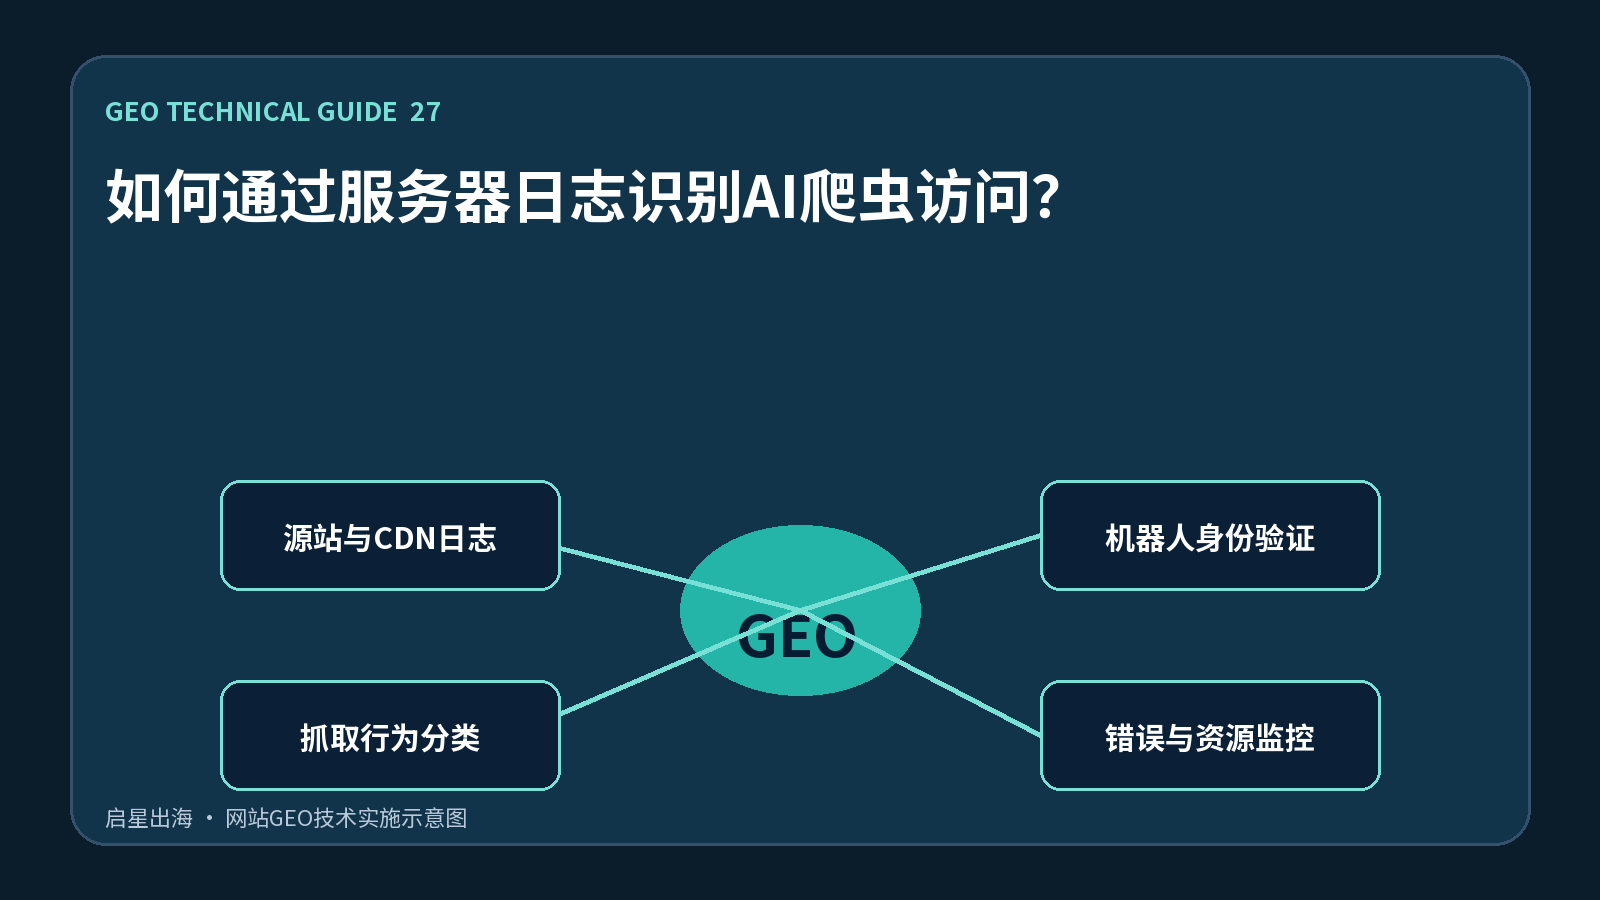
Eine Anfrage in einem Protokoll entspricht nicht einem indizierten oder zitierten Inhalt, sondern zeigt an, ob der Zugriff stattgefunden hat, welche Seiten besucht wurden, von 403 oder 429 gestoppt wurden und ob die Reptilien in einem Parameterzyklus gefangen wurden. Echte Robotererkennung kann mit dem offiziell veröffentlichten IP-Bereich oder Reverse und dem DNS-Validierungsprozess erfolgen. Das CDN-Log, das Source-Log und das Application-Log sollten die gleiche Zeit haben und die ID anfordern, um den Ort zu finden, an dem das Abfangen stattgefunden hat.
Definiert den Protokollaufbewahrungszyklus und Datenschutz-Desensibilisierungsregeln und erstellt dann eine Auflösungsmission, die bekannte Suchreptilien, KI-Suchreptilien, Trainingsreptilien und gewöhnliche Roboter klassifiziert. Speichert den ursprünglichen User-Agenten, validiert die Ergebnisse, URL-Typ, Statuscode, Antwortzeit und Cache. Erstellt Dashboards, um tägliche Greifer, Hot-Door-Pfade, Fehlerraten und neue Roboter zu sehen. Legt Regeln für Backstage, Suchparameter und unbegrenzte Seitenumbrüche fest, um zu verhindern, dass Roboter Ressourcen verbrauchen.
Die Überwachung konzentriert sich auf die effektive Erfassungsrate der öffentlichen Kernseite, den abnormalen Statuscode, das Abrufverhältnis, die Zeit vom Update bis zum Rückkehrbesuch und die Verteilung der Robotik.
Ein häufiger Fehler ist, dass alle Anfragen, die einen Bot enthalten, als glaubwürdig angesehen werden, nur GA4 lesen, vollständige IP auf unbestimmte Zeit behalten, Datenschutzanforderungen außer Acht lassen oder den Zugriff auf Reptilien als GEO-Effekt behandeln. Logs können nur den Zugriff nachweisen und müssen letztendlich weiterhin Indexierungs-, Zitier-, Fluss- und Konversionsdaten kombinieren.
Wenn Sie landen, sollten "Quellstationen und CDN-Protokolle, Roboteridentifikation, Erfassungsverhaltensklassifizierung, Fehler- und Ressourcenüberwachung" in die gleiche Release-Checkliste aufgenommen werden, in der angegeben ist, wer für den Inhalt verantwortlich ist, wer für den Inhalt verantwortlich ist Technologie und Datum der Überprüfung. Jede Änderung muss von einer Überprüfung des sichtbaren Inhalts der Seite, des HTML-Quellcodes, strukturierter Daten, interner Links und Site-Maps begleitet werden, um zu vermeiden, dass die Rezeption aktualisiert wurde und die Maschinenleseschicht die alten Werte beibehält. GEO ist kein einmaliges Installations-Plugin und garantiert nicht, dass eine Plattform zitiert wird; es ist eine Reihe von Inhalten und technischen Projekten, die die Zugänglichkeit, Validierung, Zuordnung und Zitierung von Informationen kontinuierlich verbessern.