
服务器日志怎样帮助发现SEO抓取问题
POST

服务器日志怎样帮助发现SEO抓取问题

围绕服务器日志怎样帮助发现SEO抓取问题,讲清判断依据、实施方法、验证指标和常见风险,帮助网站获得更稳定的抓取、收录与有效自然流量。

小型网站处理“服务器日志怎样帮助发现SEO抓取问题”时,不需要复制大型平台的复杂系统。先解决前端分析工具看不到爬虫请求,服务器日志能还原搜索机器人实际访问,把最重要的十到二十个网页做对,通常比部署一整套昂贵工具更有效。
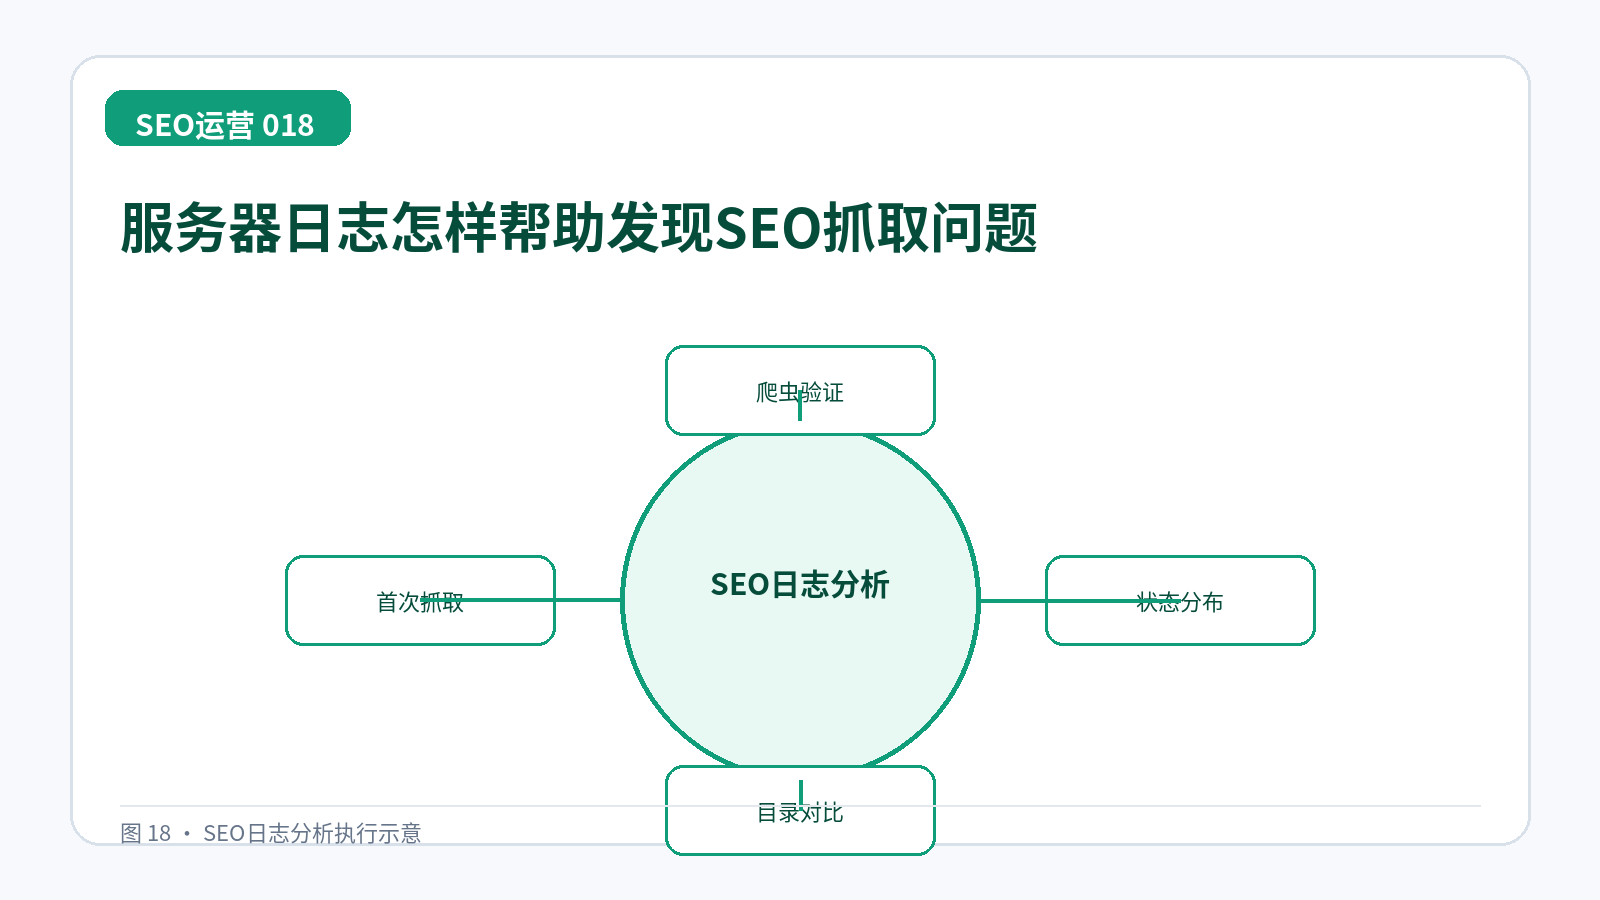
服务器日志怎样帮助发现SEO抓取问题技术示意图,展示爬虫验证、状态分布、目录对比、首次抓取
图18 服务器日志怎样帮助发现SEO抓取问题:实施示意图

最低可行标准来自这个原理:通过验证爬虫身份、状态码、路径、时间和响应耗时,可以发现浪费与遗漏。只要URL、内容、链接和状态信号一致,后续再增加自动化;如果基础关系混乱,工具只会更快地产生更多错误。

可以先人工完成:保留原始日志,反向DNS验证重要爬虫,按目录统计200、3xx、4xx、5xx和抓取频率,再与站点地图对比。当网页数量增长后,再把重复步骤写进CMS字段、模板测试和定时监控,避免每次上线依赖个人记忆。

重点看核心URL是否被持续抓取、异常状态是否集中、上线到首次抓取需要多久。验证通过后才扩大到下一批网页。需要注意只按User-Agent相信机器人身份会把伪造请求计入分析;日志也不能直接等同于索引表现。有限资源应该优先投向能被搜索、能解释产品、能带来有效咨询的网页。

如果项目组资源有限,先把这项方法用于能产生询盘或承担重要导航的网页。等状态分布与目录对比都能稳定通过,再扩展到低流量目录,避免核查范围过大却没有人处理表现。

还要把用户反馈纳入SEO判断。搜索数据能说明网页是否被发现,却不能完整解释答案是否清楚;客服问题、表单内容和销售留存可补足这一点,让SEO日志分析优化回到真实需求。

在维护层面,可把“SEO日志分析”加入季度抽查:随机选择新旧网页,核对配置、正文、链接和数据是否仍与当前业务一致。搜索规则和产品信息会变化,已经正确的网页也需要明确更新负责人。

相关内容

如何用统一的Schema图连接品牌、人员、服务与文章?

本文重点不是追求一次答案截图,而是建立可以重复执行和持续更新的技术流程。围绕“如何用统一的Schema图连接品牌、人员、服务与文章?”,首先要把用统一的Schema图连接品牌、人员、服务与文章放回“实体关系与结构化数据”的完整流程中判断。统一Schema图使用稳定@id连接Organization、WebSite、Person、Service、Product和Article。每个节点只声明真实属性,页面之间引用同一实体而不是重复造新对象。这意味着页面既要给用户清楚结论,也要让抓取器取得相同信息,并保留来源、条件与更新时间。

查看详情 →

多语言内容如何避免直接翻译造成事实偏差?

先说结论:这项工作必须围绕真实、公开且可核验的事实展开,不能靠增加标签或重复关键词取得稳定引用。围绕“多语言内容如何避免直接翻译造成事实偏差?”,首先要把多语言内容避免直接翻译造成事实偏差放回“多语言与本地化”的完整流程中判断。多语言内容不能只追求语句通顺,还要保证参数、币种、法规、服务范围和联系人没有被翻错。机器翻译适合初稿,但专业事实需要对应负责人复核。这意味着页面既要给用户清楚结论,也要让抓取器取得相同信息,并保留来源、条件与更新时间。

查看详情 →

本地化页面怎样体现国家市场的真实差异?

本题没有适合所有网站的固定配置,正确方案取决于页面用途、目标市场、数据来源和企业能够长期维护的范围。围绕“本地化页面怎样体现国家市场的真实差异?”,首先要把本地化页面体现国家市场的真实差异放回“多语言与本地化”的完整流程中判断。国家页应展示真实可提供的语言、交付、认证、案例和联系安排。仅替换国家名称和旗帜,不构成独特本地价值。这意味着页面既要给用户清楚结论,也要让抓取器取得相同信息,并保留来源、条件与更新时间。

查看详情 →


