
站内搜索结果页应不应该进入搜索与AI索引?
POST

站内搜索结果页应不应该进入搜索与AI索引?

本文重点不是追求一次答案截图,而是建立可以重复执行和持续更新的技术流程。围绕“站内搜索结果页应不应该进入搜索与AI索引?”,首先要把站内搜索结果页应不进入搜索与AI索引放回“抓取渲染与索引控制”的完整流程中判断。站内搜索页通常组合无限、内容不稳定,不适合作为大规模索引入口。持续出现的高价值查询可转化成正式分类、专题或FAQ页面。这意味着页面既要给用户清楚结论,也要让抓取器取得相同信息,并保留来源、条件与更新时间。
回答解析

本文重点不是追求一次答案截图,而是建立可以重复执行和持续更新的技术流程。围绕“站内搜索结果页应不应该进入搜索与AI索引?”,首先要把站内搜索结果页应不进入搜索与AI索引放回“抓取渲染与索引控制”的完整流程中判断。站内搜索页通常组合无限、内容不稳定,不适合作为大规模索引入口。持续出现的高价值查询可转化成正式分类、专题或FAQ页面。这意味着页面既要给用户清楚结论,也要让抓取器取得相同信息,并保留来源、条件与更新时间。

站内搜索结果页应不应该进入搜索与AI索引?
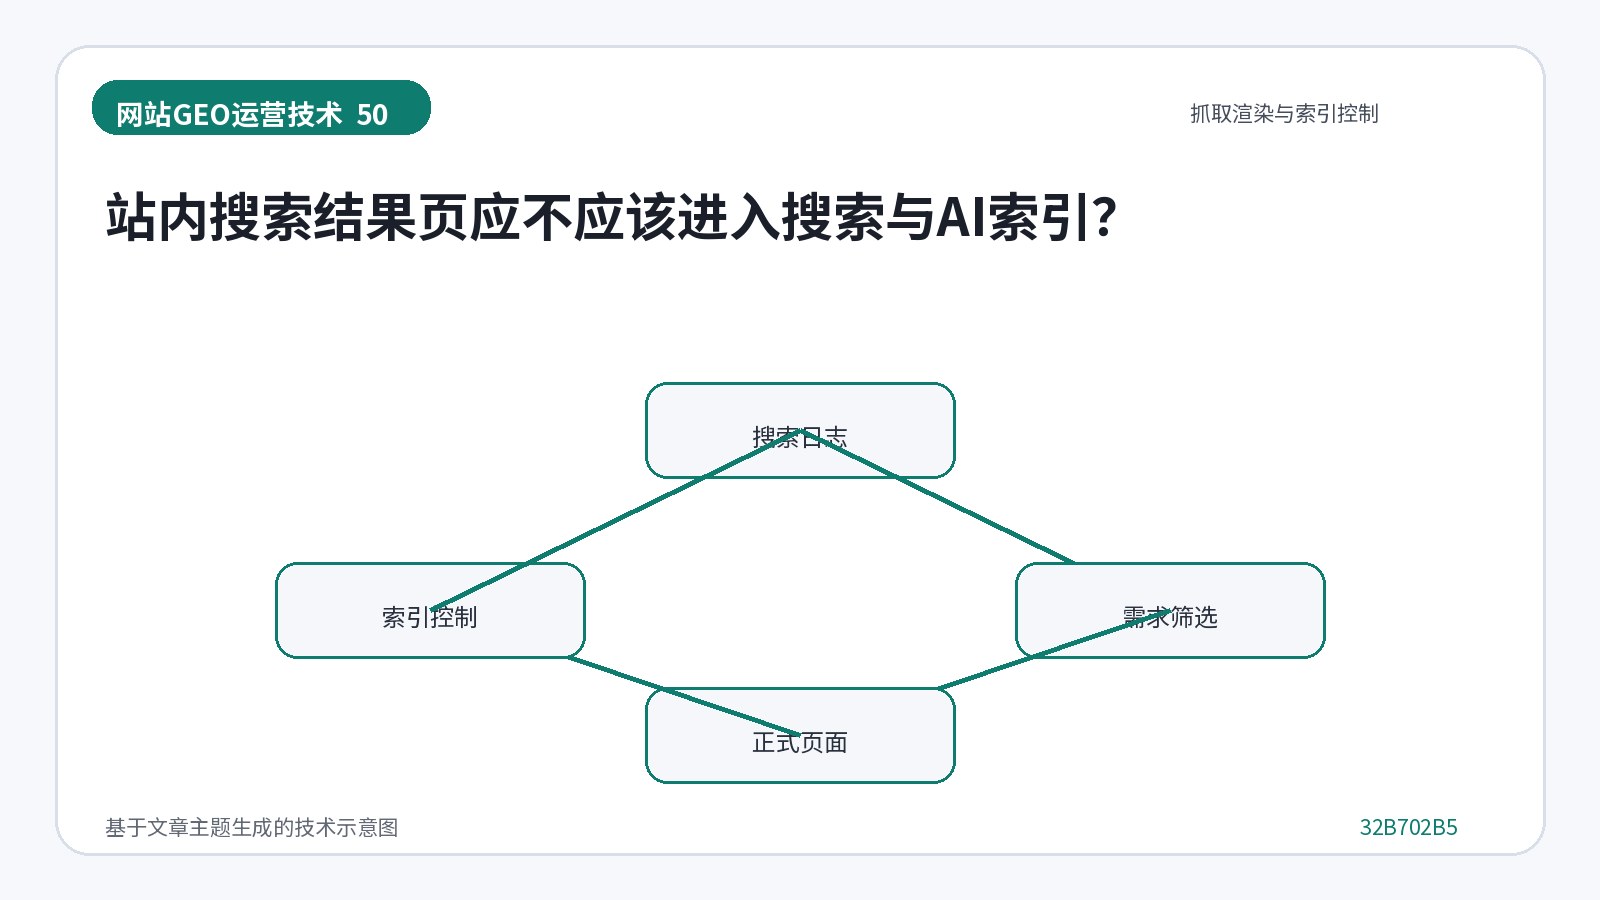
图50 站内搜索结果页应不应该进入搜索与AI索引?技术示意图

答案系统无法稳定使用它拿不到的正文。初始HTML、状态码、链接、规范网址和渲染资源决定页面是否可发现;技术检查必须基于实际抓取结果,而不是只看浏览器显示。页面上线后可以先观察两类问题:系统是否取得正确内容,用户是否获得完整条件。前者依靠抓取和结构检查,后者通过阅读路径、表单字段与销售反馈确认。

落地时要把动作写到CMS与运营流程中,而不是只留在会议记录。先分析站内搜索日志,再筛选有业务价值的稳定问题,完成后通过创建正式页面并限制其余动态结果验证并设置下一次复核日期。团队可以用“问题—页面—证据—结果”四列建立记录。本题对应的问题是站内搜索结果页应不进入搜索与AI索引,页面承担解释任务,证据来自受控资料,结果则由引用准确度和客户下一步共同判断。

观察口径必须固定。比较参数URL数量、正式页面表现和用户搜索后的退出率。样本不足时只记录方向,不应根据单日或单次回答得出确定结论。

常见返工并非工具设置错误,而是直接屏蔽抓取前要确认爬虫仍能读取需要的noindex指令。解决办法是把关键判断固化到发布检查表,并让审核人签字确认。任何无法证明的结论都应改成条件性建议,不能为了营销把推测写成事实。

官方参考:Google AI功能与网站

正文长度:620字|板块:网站GEO优化|分类:抓取渲染与索引控制

相关内容

如何用统一的Schema图连接品牌、人员、服务与文章?

本文重点不是追求一次答案截图,而是建立可以重复执行和持续更新的技术流程。围绕“如何用统一的Schema图连接品牌、人员、服务与文章?”,首先要把用统一的Schema图连接品牌、人员、服务与文章放回“实体关系与结构化数据”的完整流程中判断。统一Schema图使用稳定@id连接Organization、WebSite、Person、Service、Product和Article。每个节点只声明真实属性,页面之间引用同一实体而不是重复造新对象。这意味着页面既要给用户清楚结论,也要让抓取器取得相同信息,并保留来源、条件与更新时间。

查看详情 →

多语言内容如何避免直接翻译造成事实偏差?

先说结论:这项工作必须围绕真实、公开且可核验的事实展开,不能靠增加标签或重复关键词取得稳定引用。围绕“多语言内容如何避免直接翻译造成事实偏差?”,首先要把多语言内容避免直接翻译造成事实偏差放回“多语言与本地化”的完整流程中判断。多语言内容不能只追求语句通顺,还要保证参数、币种、法规、服务范围和联系人没有被翻错。机器翻译适合初稿,但专业事实需要对应负责人复核。这意味着页面既要给用户清楚结论,也要让抓取器取得相同信息,并保留来源、条件与更新时间。

查看详情 →

本地化页面怎样体现国家市场的真实差异?

本题没有适合所有网站的固定配置,正确方案取决于页面用途、目标市场、数据来源和企业能够长期维护的范围。围绕“本地化页面怎样体现国家市场的真实差异?”,首先要把本地化页面体现国家市场的真实差异放回“多语言与本地化”的完整流程中判断。国家页应展示真实可提供的语言、交付、认证、案例和联系安排。仅替换国家名称和旗帜,不构成独特本地价值。这意味着页面既要给用户清楚结论,也要让抓取器取得相同信息,并保留来源、条件与更新时间。

查看详情 →


