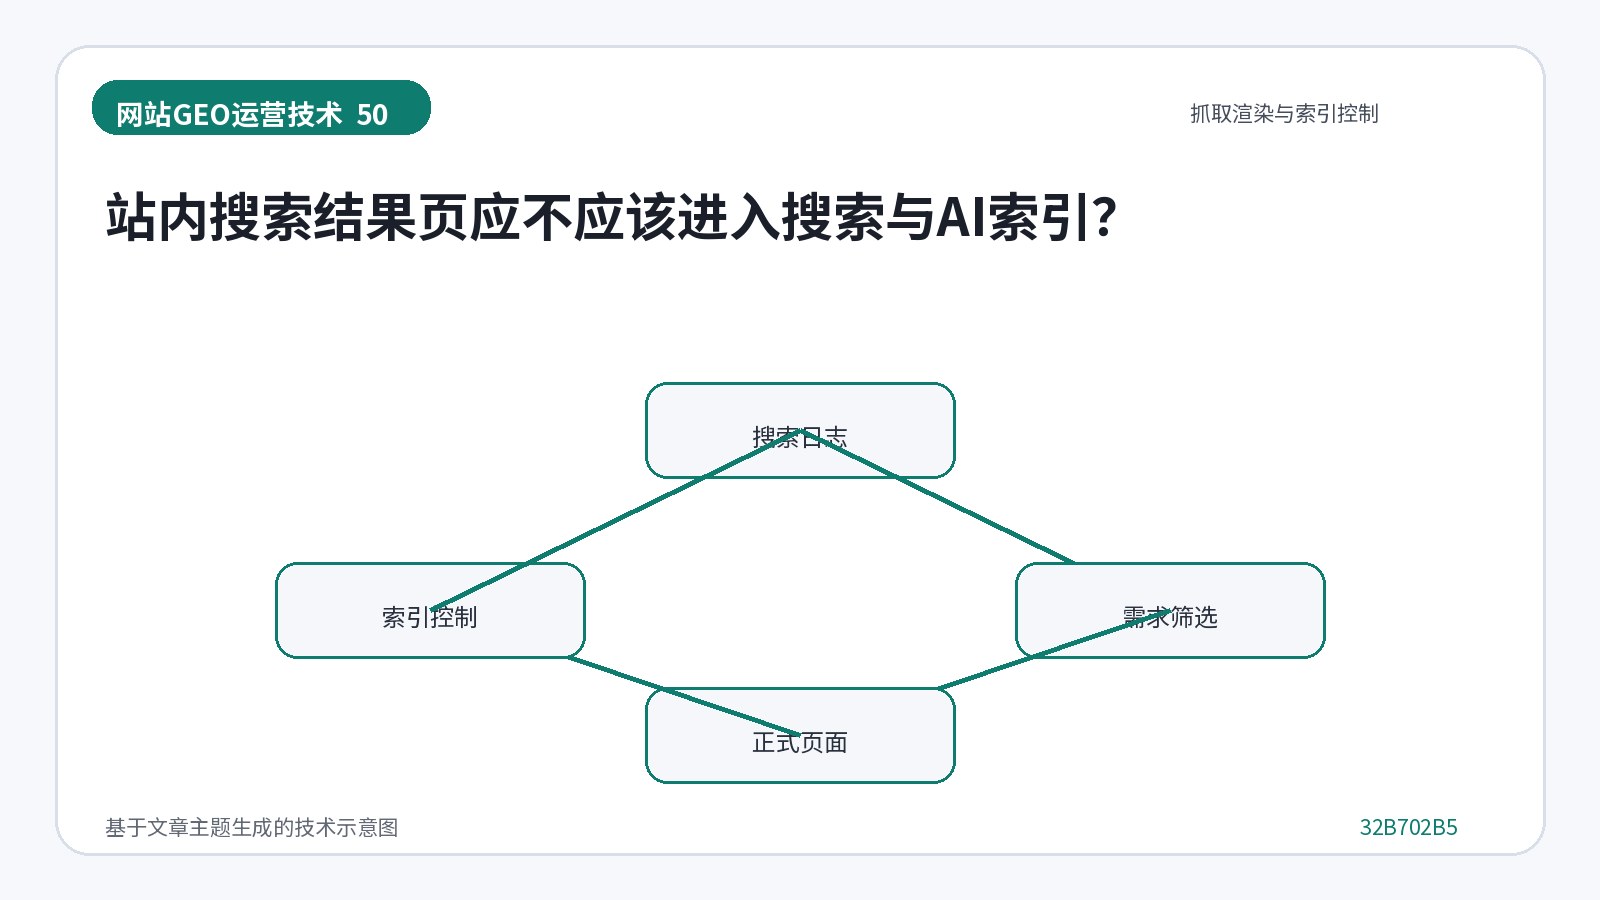
Le but de ce document n'est pas de poursuivre une capture d'écran de réponse, mais de créer un processus technique qui peut être répété et continuellement mis à jour. La page des résultats de recherche autour du site devrait aller à la recherche et l'index AI? ) Premièrement, la page des résultats de recherche ne devrait pas entrer dans la recherche complète et l'index AI et être jugée par la recherche et l'index AI à nouveau dans le processus complet de capture de rendu et de contrôle de l'index. Les pages de recherche dans le site sont généralement dans une combinaison illimitée, unstable dans le contenu, et ne conviennent pas pour l'accès à grande échelle à l'index. Cela signifie que la page nécessite à la fois des conclusions claires pour les utilisateurs et les personnes qui capturent pour obtenir les mêmes informations et pour conserver les sources, les conditions et les mises à jour.
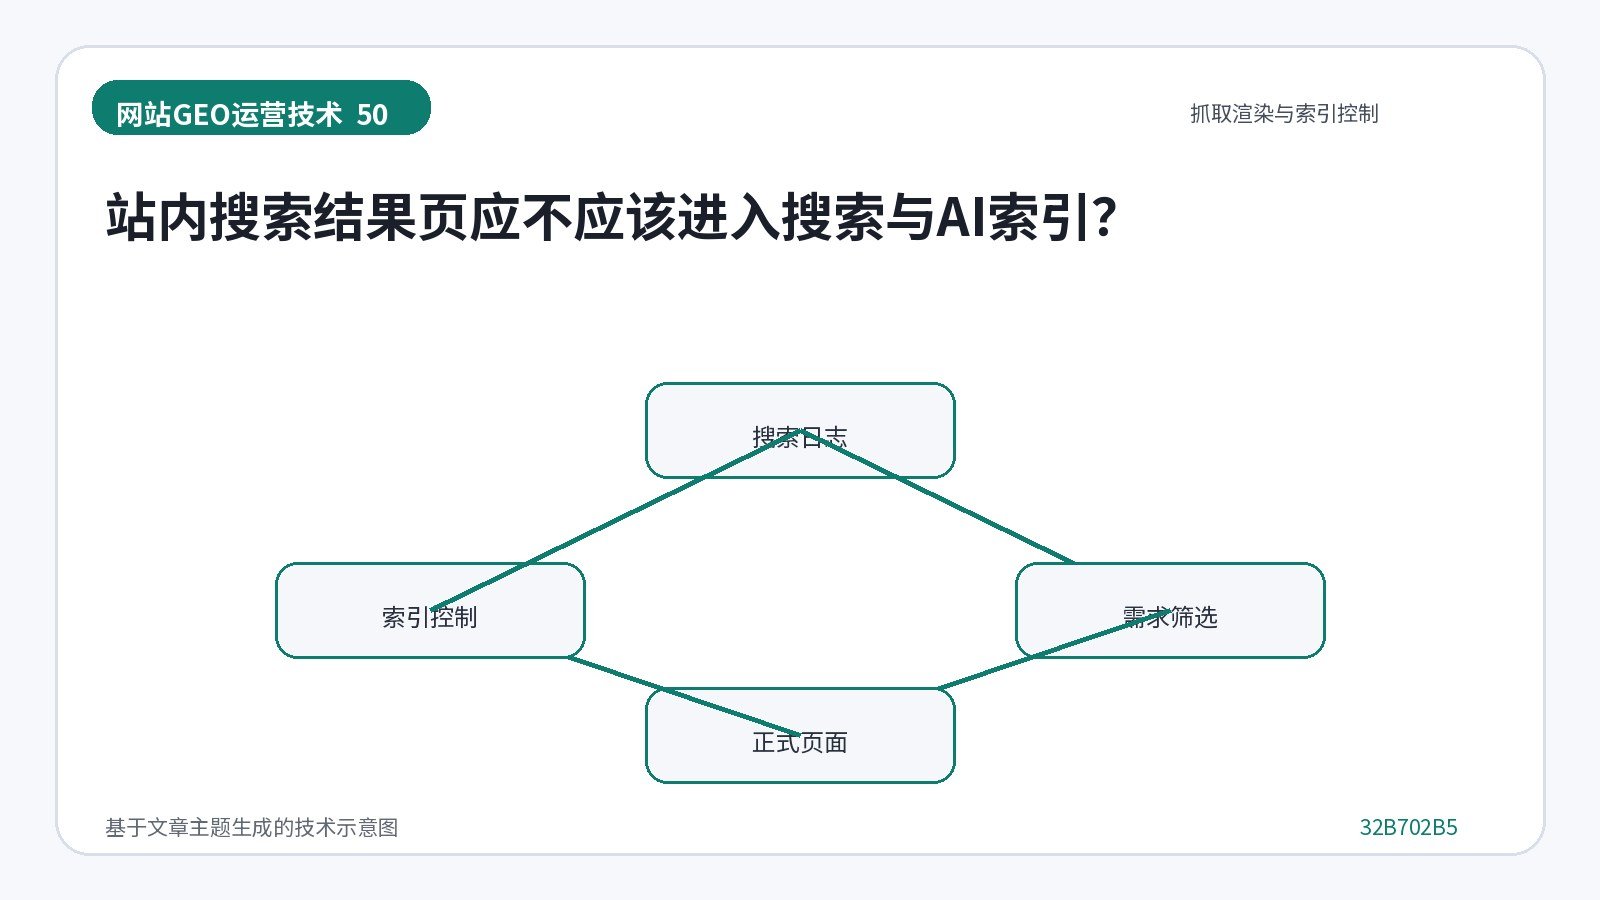
Le système de réponse n'est pas en mesure d'utiliser le texte qu'il ne peut atteindre de manière stable. Le HTML initial, le code d'état, le lien, le site Web normatif et les ressources de rendu déterminent si la page peut être trouvée; la vérification technique doit être basée sur les résultats réels de capture, plutôt que de simplement regarder l'affichage du navigateur. Les deux types de questions peuvent être vus en premier sur la page: si le système a le contenu correct et si l'utilisateur a la condition complète. Le premier repose sur les contrôles de capture et de structure, tandis que le second est confirmé par les chemins de lecture, les champs de table et la rétroaction des ventes.
Lorsque vous atterrissez, vous devez écrire des actions dans le CMS et le processus opérationnel, plutôt que de les laisser dans le procès-verbal de la réunion. Tout d'abord, vous recherchez les journaux dans la station d'analyse, puis écran pour des questions stables de valeur commerciale, puis validez et définissez une date pour le prochain examen en créant une page formelle et en limitant les résultats dynamiques restants. L'équipe peut l'enregistrer dans les quatre colonnes « Issues-page-preuve-results » . Le problème avec ce sujet est que la page de résultat de recherche à l'intérieur du site ne devrait pas entrer dans l'index de recherche et d'IA, et la page devrait avoir la tâche de l'expliquer. La preuve provient de l'information contrôlée, et le résultat sera jugé en fonction de l'exactitude et du prochain client.
L'étalonnage d'observation doit être corrigé. Comparez le nombre d'URL, la performance officielle de la page et le taux de sortie après la recherche utilisateur.
Le retour commun n'est pas une erreur dans le réglage des outils, mais une directive noindex pour protéger directement les reptiles avant qu'ils puissent être capturés. La solution est d'ancrer les jugements clés dans la publication de la liste de contrôle et de faire signer aux examinateurs pour confirmer. Toute conclusion non prouvée devrait être changée en recommandation conditionnelle, et aucune spéculation ne devrait être écrite comme un fait à des fins de marketing.