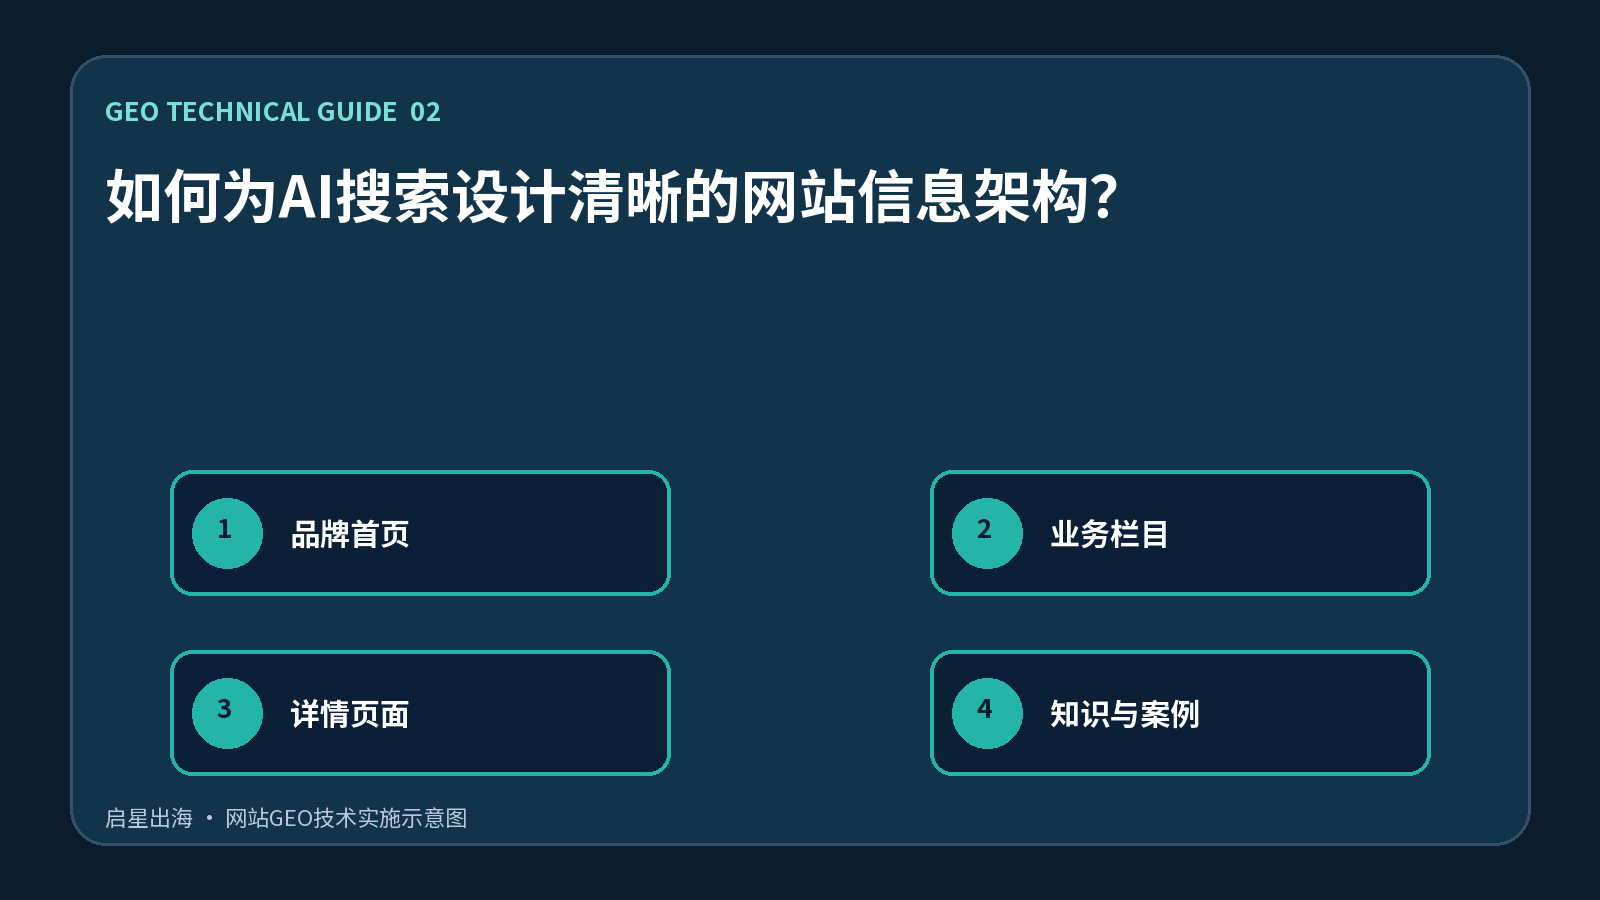
Lorsque le système d'IA comprend le site Web, il ne lit pas seulement la première page, mais intègre plutôt la navigation, l'URL, la chapelure, les liens internes et les relations de thème de page. Si les produits, services, cours, cas et articles sont tous dans une colonne, ou si le nom de navigation n'est pas compatible avec le thème de la page, il est difficile pour la machine de juger les tâches effectuées par chaque page. Une structure d'information claire devrait permettre aux visiteurs et aux reptiles de répondre à trois questions : le type de contenu, le thème auquel il appartient, et la page suivante.
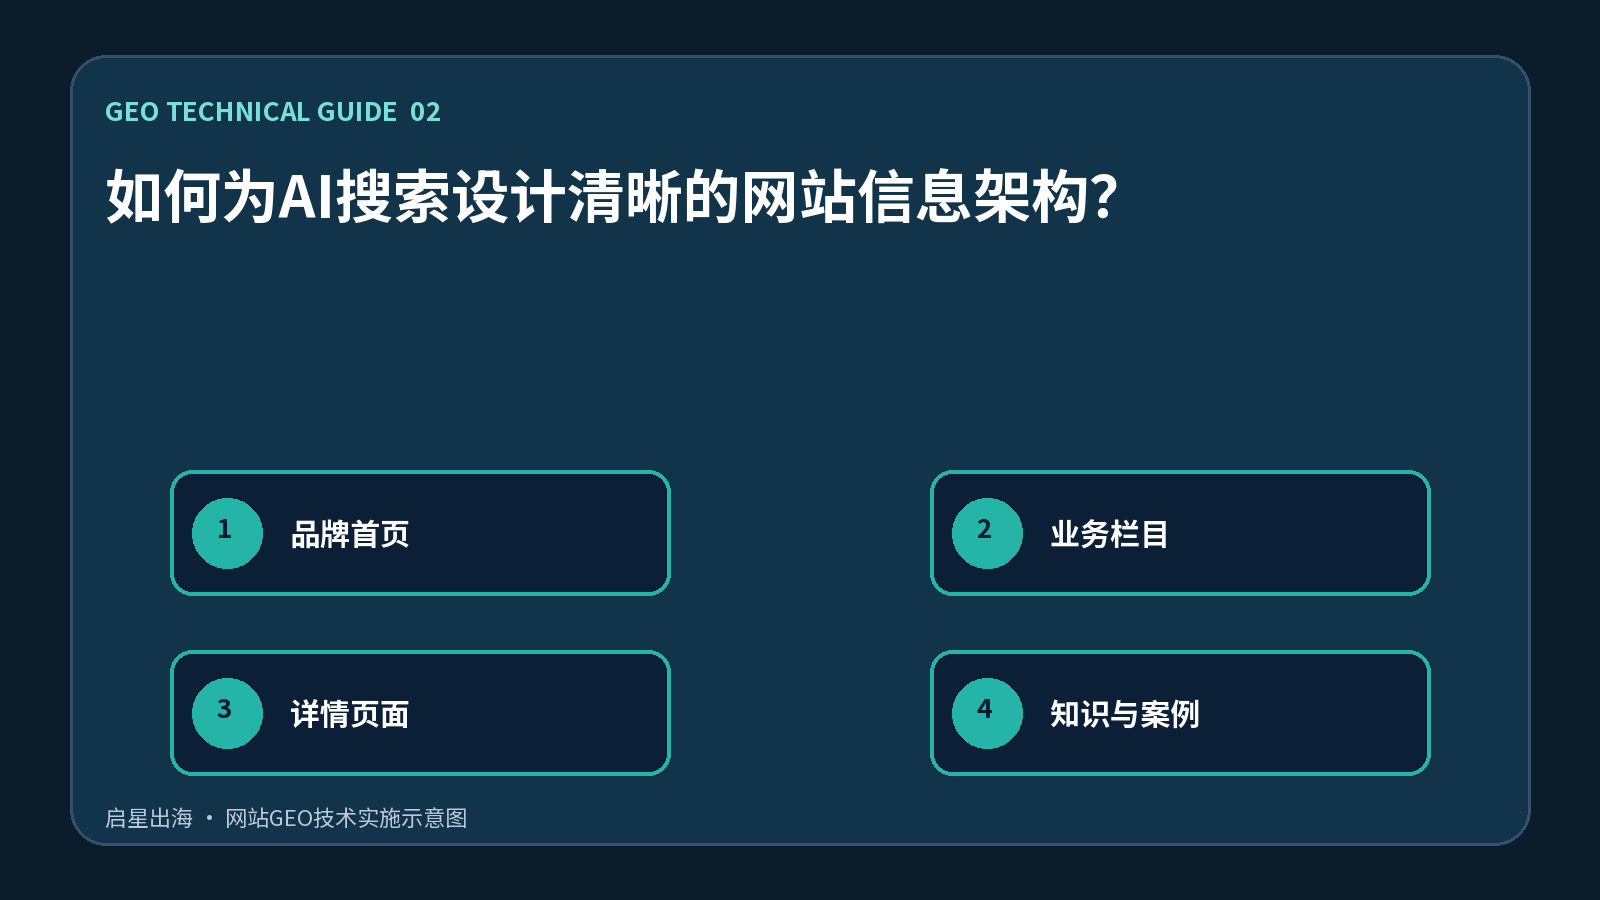
La première page représente les marques et le positionnement de base, les colonnes de premier niveau représentent les grappes d'entreprises, les pages détaillées représentent un seul produit ou service, les articles de connaissances expliquent les questions d'approvisionnement et les pages de cas fournissent des preuves de résultats. Les béquilles de pain et les chaînes de contexte relient ces nœuds. Les réponses AI lors de la combinaison d'informations sont plus faciles à extraire des pages avec des frontières thématiques claires, et à placer des cas, experts et produits sous la même entité commerciale.
Une liste de contenu est créée pour chaque URL, indiquant le type de contenu, le thème principal, le client cible et la cible de transformation. Voici une combinaison de colonnes dupliquées pour éviter plusieurs chemins incohérents pour le même service. Il est proposé d'adopter la structure de la page d'accueil de la marque — secteur d'activité — pages détaillées — articles de connaissance — éléments de preuve — et de présenter un profil, une liste de sous-pages et des questions communes pour chaque domaine d'activité. La navigation est limitée aux entrées de grande valeur, les articles à longue queue se trouvent dans la page de classification et dans la chaîne interne.
Utilisez l'outil reptile pour exporter la profondeur de clic, les pages isolées, les chaînes de redirection et les titres dupliqués pendant la validation. La page de service de base devrait de préférence atteindre dès la première page avec un petit nombre de clics, mais sans la poursuite mécanique de toutes les pages à la même profondeur. Le journal et le chemin utilisateur doivent également être recherchés à l'intérieur du point de contrôle: Si le visiteur retourne de l'article à la première page, la relation entre l'article et le produit n'est pas claire.
Le problème le plus courant est de couvrir le nombre croissant de catégories similaires de mots-clés, qui se traduisent par plusieurs colonnes minces; ou de surpasser la navigation sans une description des rubriques de cluster elles-mêmes. Un autre risque est que la redirection 301 soit définie après avoir changé le chemin de colonne, conduisant à l'invalidation des anciennes liaisons, des références canoniques et externes. L'architecture de l'information devrait donner la priorité à la classification opérationnelle réelle du service plutôt qu'à la transformation directe du mot-clé en menu.
Lorsque vous atterrissez, les pages d'accueil de marque, les champs d'affaires, les pages détaillées, les connaissances et les cahiers de cas doivent être inclus dans la même liste de contrôle de diffusion, en précisant qui est responsable du contenu, qui est responsable de la technologie, et la date de révision. Tout changement doit être accompagné d'un examen du contenu visible de la page, du code source HTML, des données structurées, des liens internes et des cartes du site, afin que la réception ne soit pas mise à jour et que les couches de lecture automatique restent des valeurs anciennes. GEO n'est pas un plugin d'installation unique et ne garantit pas qu'une plate-forme sera citée; il s'agit d'un ensemble de contenus et de travaux techniques qui améliore continuellement l'accessibilité, la validation, l'attribution et la citation des informations.