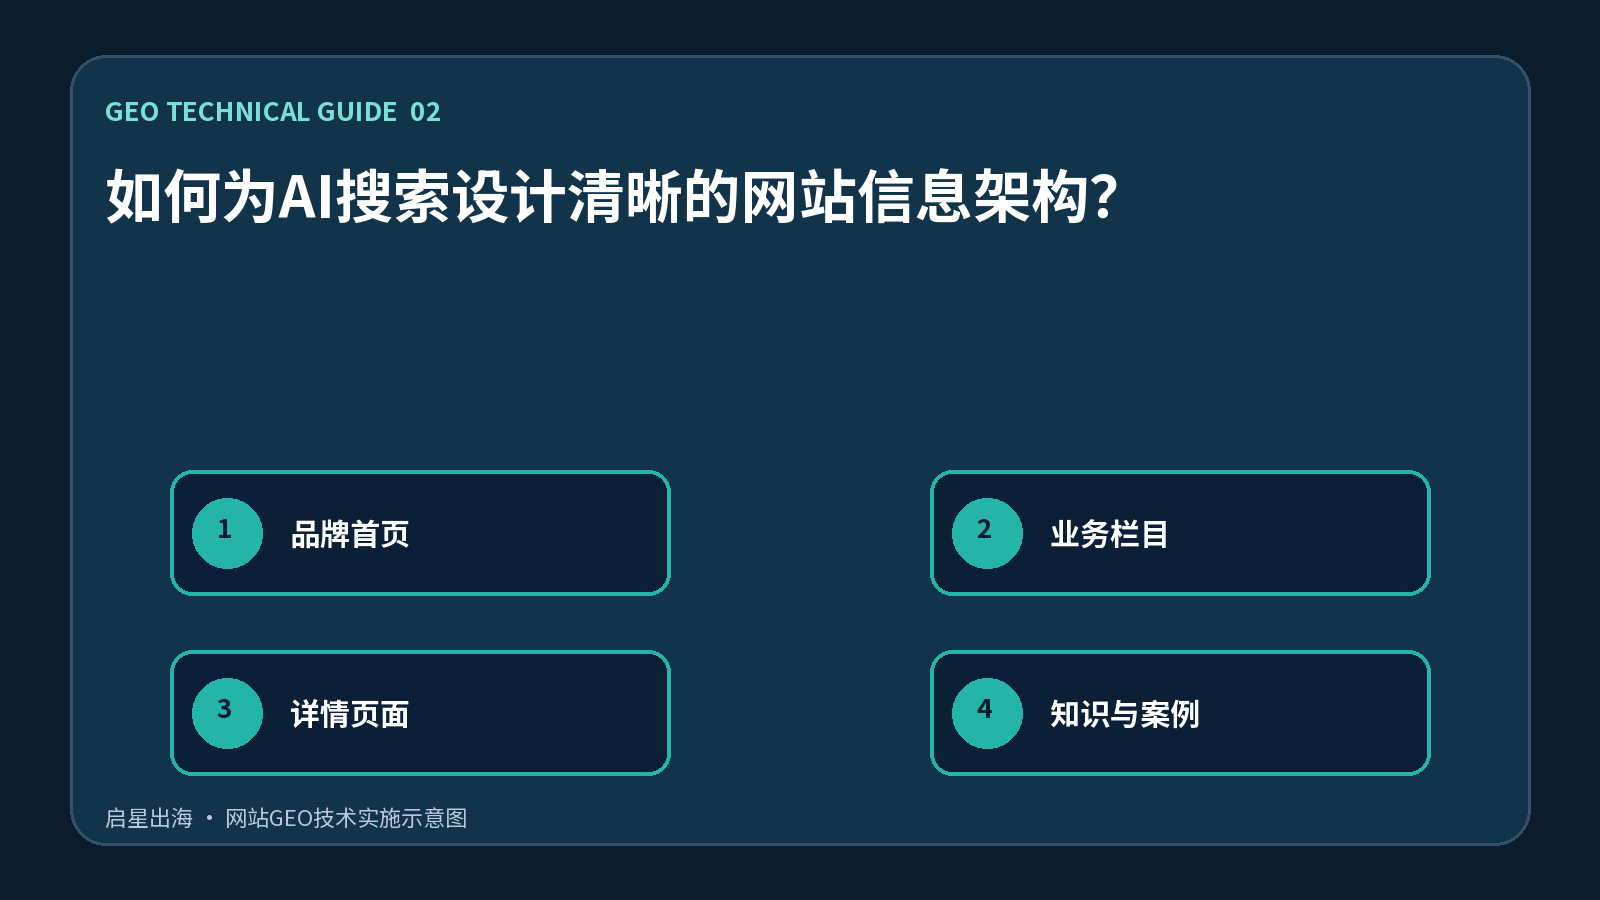
Cuando el sistema AI entiende el sitio web, no lee sólo la primera página, sino que integra la navegación, URL, pantuflas, enlaces internos y relaciones temáticas de página. Si los productos, servicios, cursos, casos y artículos están todos en una columna, o si el nombre de navegación no es compatible con el tema de la página, es difícil para la máquina juzgar las tareas realizadas por cada página. Una estructura de información clara debe permitir que los visitantes y reptiles respondan a tres preguntas: el tipo de contenido, que le pertenece, y qué página debe ser visitada a continuación.
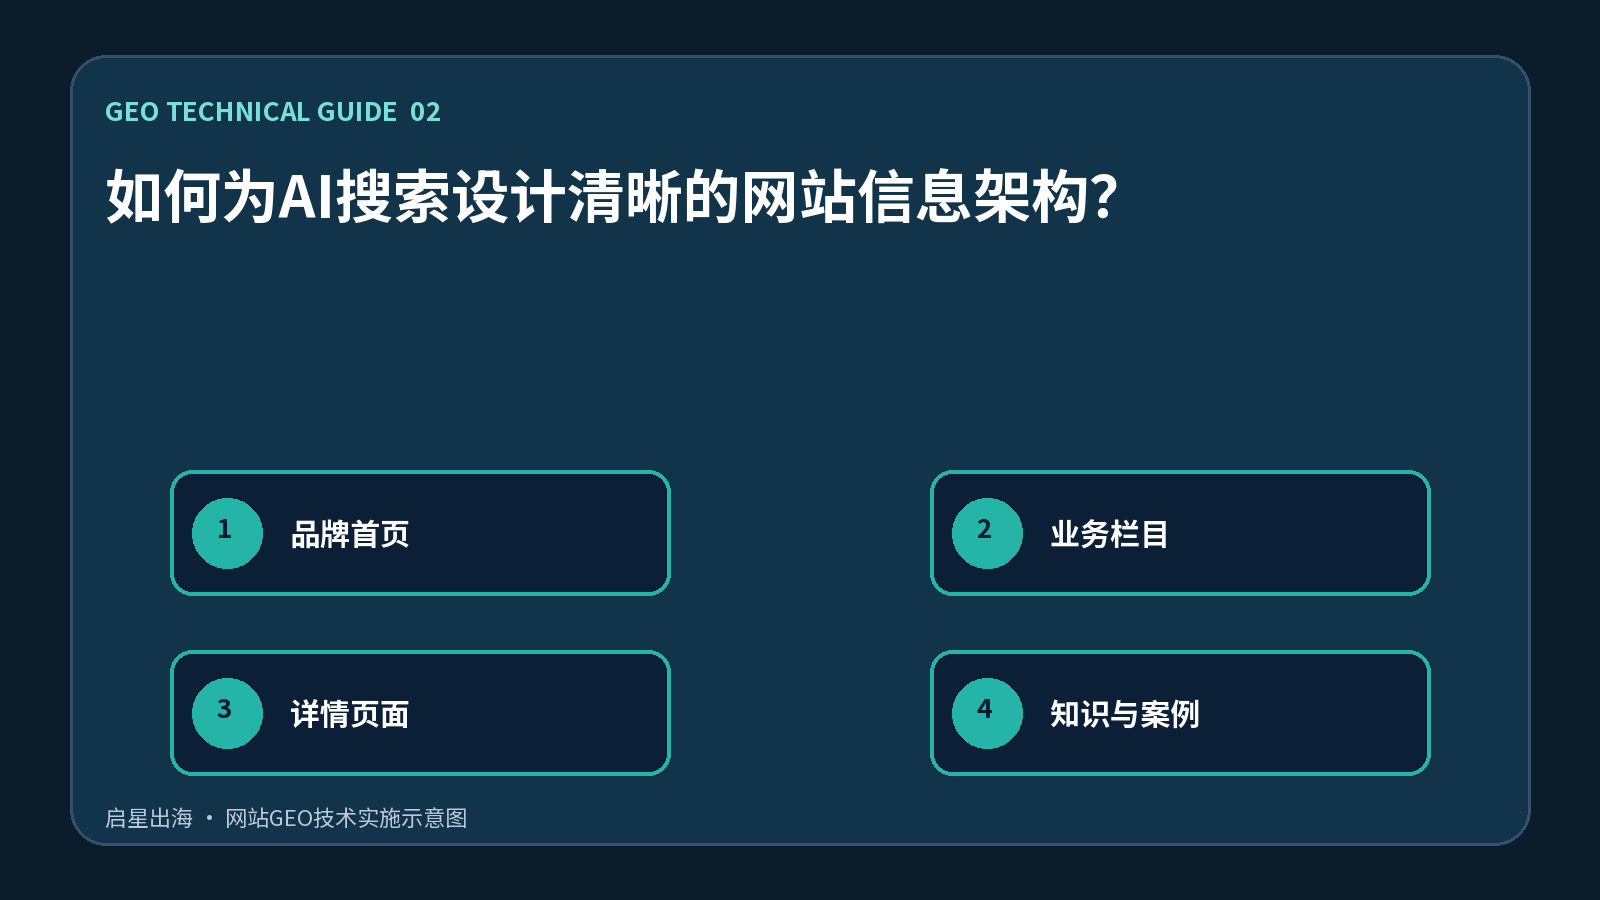
La primera página representa marcas y posicionamiento básico, las columnas de primer nivel representan grupos de negocios, páginas detalladas representan un solo producto o servicio, artículos de conocimiento explican cuestiones de adquisición, y las páginas de casos proporcionan evidencia de resultados. Las migajas de pan y las cadenas de contexto vinculan estos nodos. Las respuestas de AI al combinar la información son más fáciles de extraer de páginas con límites temáticos claros, y colocar casos, expertos y productos bajo la misma entidad empresarial.
Se crea una lista de contenido para cada URL, indicando el tipo de contenido, el tema central, el cliente objetivo y el objetivo de transformación. Lo siguiente es una combinación de columnas duplicadas para evitar múltiples caminos inconsistentes para el mismo servicio. Se propone adoptar la estructura de la “página principal de marca — línea de negocio —páginas detalladas — artículos de conocimiento — evidencia de caso” y establecer un perfil, lista de subpáginas y preguntas comunes para cada campo de negocios. La navegación se limita a entradas de alto valor, artículos de cola larga se encuentran en la página de clasificación y en la cadena interior.
Utilice la herramienta reptil para exportar profundidad de clics, páginas aisladas, redireccionar cadenas y duplicar títulos durante la validación. La página de servicio principal debe llegar preferentemente desde la primera página con un pequeño número de clics, pero sin la búsqueda mecánica de todas las páginas a la misma profundidad. La ruta de registro y usuario también debe buscarse dentro del punto de control: Si el visitante regresa del artículo a la primera página, la relación entre el artículo y el producto no está clara.
El problema más común es cubrir el número cada vez mayor de categorías similares de palabras clave, que resultan en varias columnas delgadas; o sobrehacer la navegación sin una descripción de las propias partidas de racimo. Otro riesgo es que no se establezca una redirección de 301 después de cambiar el camino de la columna, lo que conduce a la invalidación de enlaces antiguos, referencias canónicas y externas. La arquitectura de la información debe dar prioridad a la clasificación de negocio real del servicio en lugar de a la transformación directa de la palabra clave en un menú.
Cuando aterrices, “páginas de marca, campos de negocios, páginas detalladas, conocimientos y cuadernos de casos” debe incluirse en la misma lista de verificación de lanzamiento, especificando quién es responsable del contenido, quién es responsable de la tecnología, y la fecha de revisión. Cualquier cambio debe ir acompañado de una revisión del contenido visible de la página, código fuente HTML, datos estructurados, enlaces internos y mapas del sitio, de modo que la recepción no se actualice y las capas de lectura de máquinas siguen siendo valores antiguos. GEO no es un plugin de instalación de una sola vez y no garantiza que ninguna plataforma será citada; es un conjunto de contenidos y obras técnicas que mejora continuamente la accesibilidad, validación, atribución y cita de información.