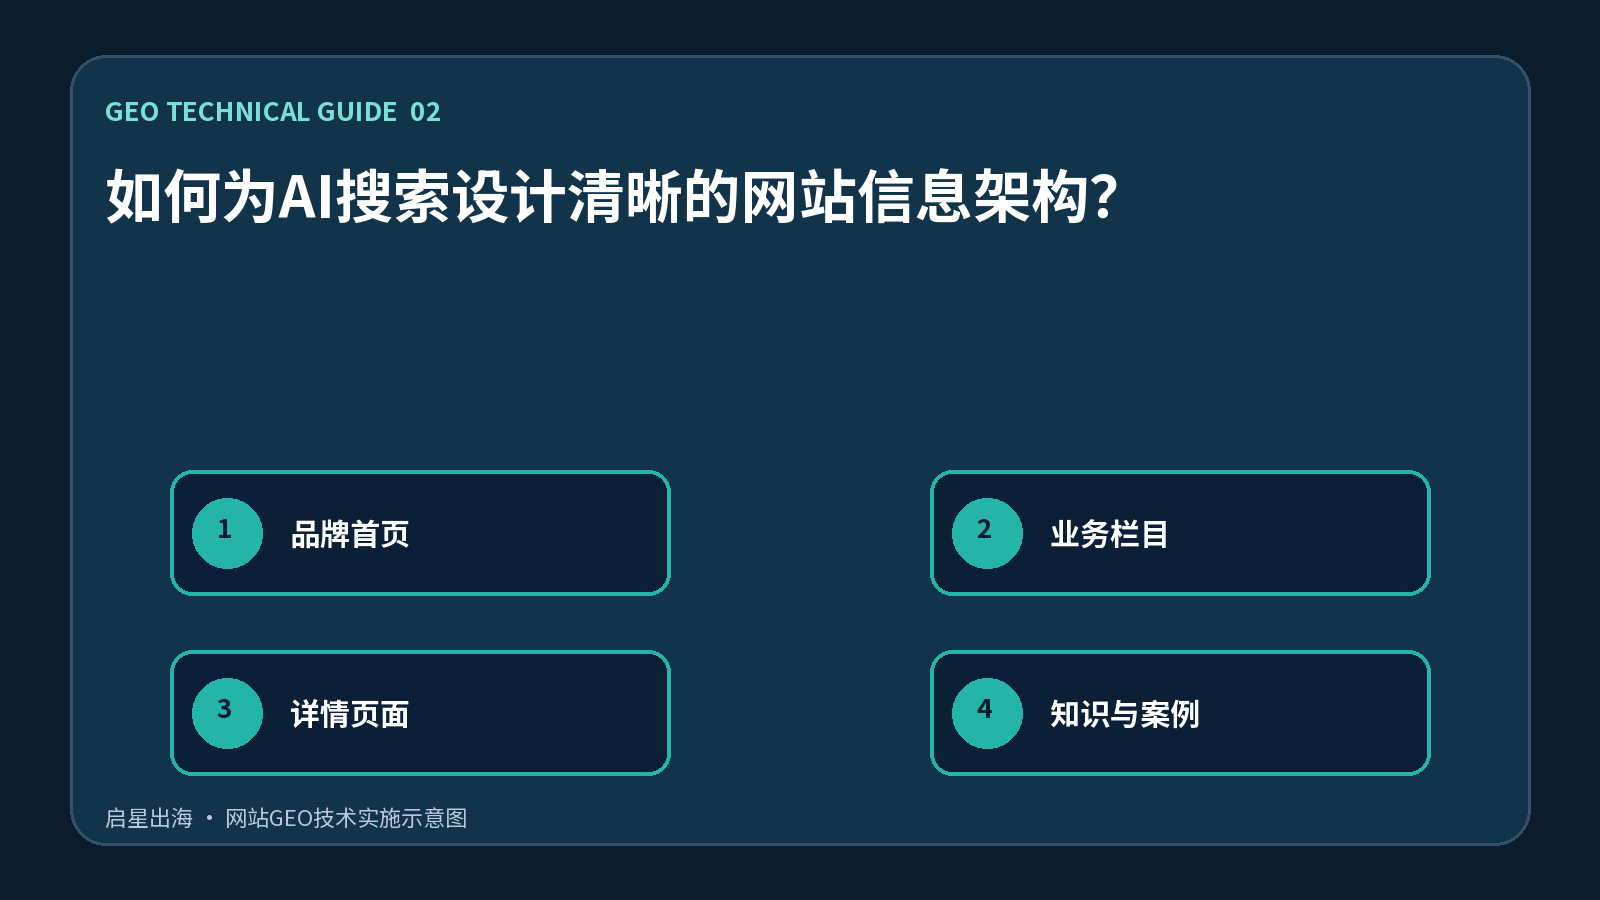
Wenn das KI-System die Website versteht, liest es nicht nur die erste Seite, sondern integriert Navigation, URL, Breadcrumbs, interne Links und Seitenthemabeziehungen. Wenn sich Produkte, Dienstleistungen, Kurse, Fälle und Artikel in einer Spalte befinden oder wenn der Navigationsname nicht mit dem Seitenthema übereinstimmt, ist es für die Maschine schwierig, die von jeder Seite ausgeführten Aufgaben zu beurteilen. Eine klare Informationsstruktur sollte es Besuchern und Reptilien ermöglichen, drei Fragen zu beantworten: Welche Art von Inhalten, zu welchem Thema sie gehören und welche Seite als nächstes besucht werden soll.
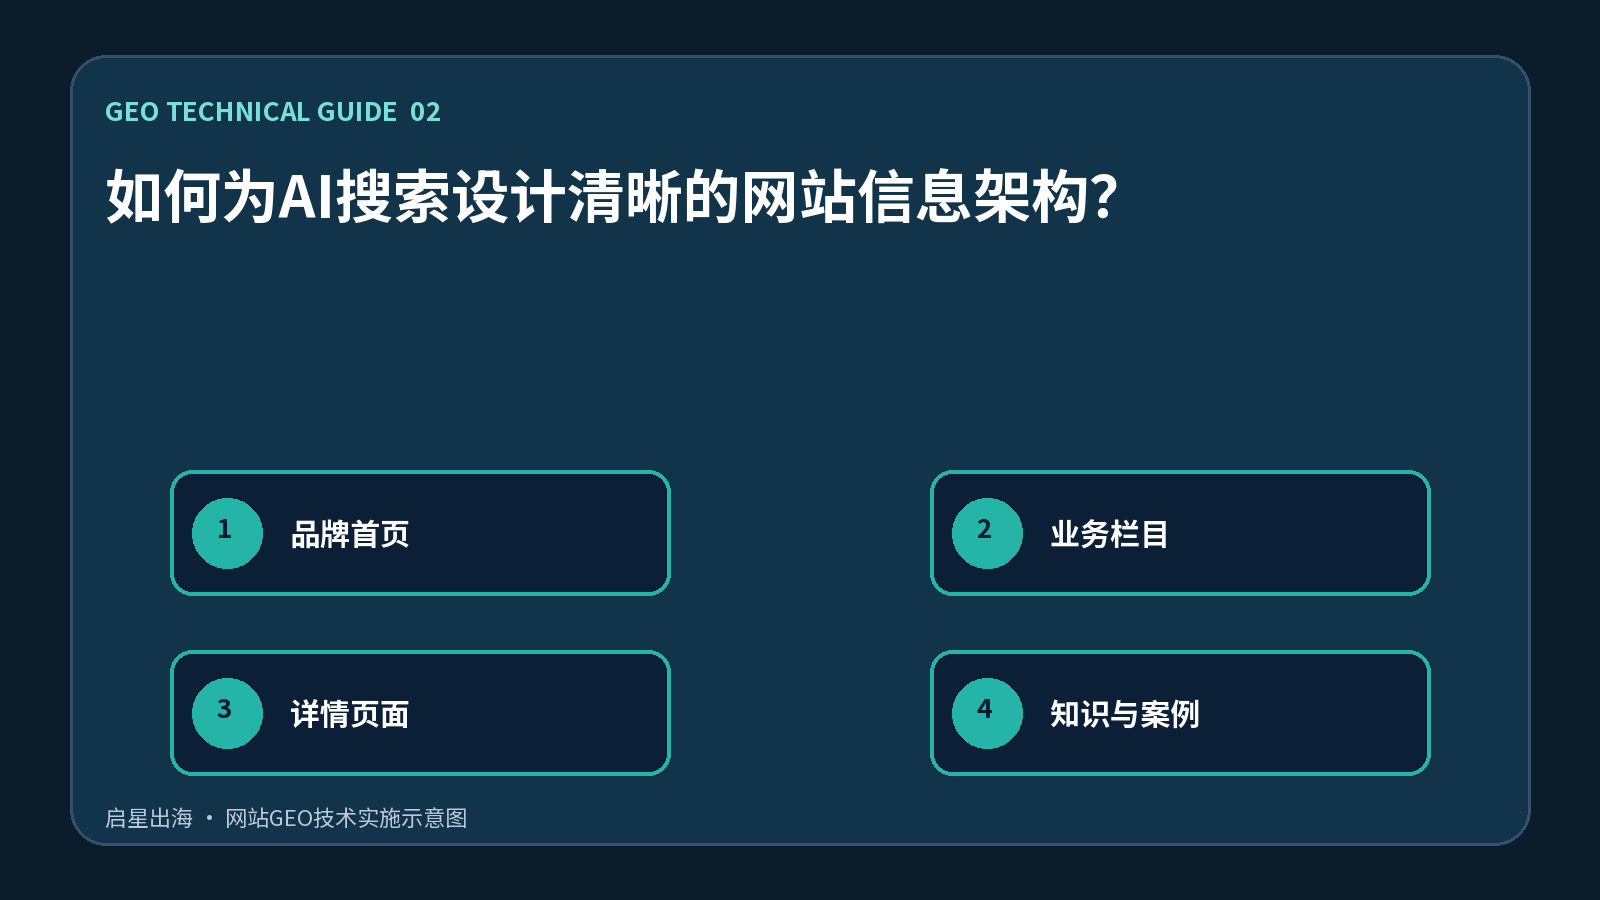
Die erste Seite stellt Marken und Kernpositionierung dar, die Spalten der ersten Ebene stellen Geschäftscluster dar, detaillierte Seiten stellen ein einzelnes Produkt oder eine einzelne Dienstleistung dar, Wissensartikel erläutern Beschaffungsprobleme und Fallseiten liefern Belege für Ergebnisse. Brotkrümel und Kontextketten verbinden diese Knoten. KI-Antworten bei der Kombination von Informationen lassen sich leichter aus Seiten mit klaren thematischen Grenzen extrahieren und Fälle, Experten und Produkte unter derselben Geschäftseinheit platzieren.
Für jede URL wird eine Inhaltsliste erstellt, in der die Art des Inhalts, das Kernthema, der Zielclient und das Transformationsziel angegeben sind. Es wird vorgeschlagen, die Struktur der "Markenkopfseite - Business Line - Detailseiten - Wissensartikel - Fallbeweise" zu übernehmen und ein Profil, eine Unterseitenliste und gemeinsame Fragen für jedes Geschäftsfeld festzulegen. Die Navigation beschränkt sich auf hochwertige Eingänge, Long-Tail-Artikel finden sich auf der Klassifikationsseite und in der inneren Kette.
Verwenden Sie das Reptil-Tool, um Klicktiefe, isolierte Seiten, Umleitung von Ketten und doppelte Titel während der Validierung zu exportieren. Die Kerndienstseite sollte vorzugsweise von der ersten Seite mit einer geringen Anzahl von Klicks, aber ohne die mechanische Verfolgung aller Seiten in der gleichen Tiefe erreichen. Auch der Log- und Benutzerpfad sollte innerhalb des Checkpoints durchsucht werden: Wenn der Besucher vom Artikel zur ersten Seite zurückkehrt, ist die Beziehung zwischen dem Artikel und dem Produkt nicht klar.
Das häufigste problem besteht darin, die zunehmende anzahl ähnlicher kategorien von keywords abzudecken, die zu mehreren dünnen spalten führen; oder die navigation zu übertreiben, ohne eine beschreibung der clusterüberschriften selbst. Ein weiteres Risiko besteht darin, dass nach dem Ändern des Spaltenpfads keine 301-Umleitung eingestellt wird, was zur Ungültigerklärung alter Links, kanonischer und externer Referenzen führt. Die Informationsarchitektur sollte der tatsächlichen Geschäftsklassifizierung des Dienstes Vorrang einräumen und nicht der direkten Umwandlung des Keywords in ein Menü.
Wenn Sie landen, sollten "Marken-Homepages, Geschäftsfelder, detaillierte Seiten, Wissen und Fallbücher" in die gleiche Release-Checkliste aufgenommen werden, in der angegeben ist, wer für den Inhalt verantwortlich ist, wer für die Technologie verantwortlich ist und das Datum der Überprüfung. Jede Änderung muss mit einer Überprüfung des sichtbaren Inhalts der Seite, des HTML-Quellcodes, strukturierter Daten, interner Links und Site-Maps einhergehen, damit die Rezeption nicht aktualisiert wird und die Ebenen für das maschinelle Lesen alte Werte bleiben. GEO ist kein einmaliges Installations-Plugin und garantiert nicht, dass eine Plattform zitiert wird; es ist eine Reihe von Inhalten und technischen Arbeiten, die die Zugänglichkeit, Validierung, Zuordnung und Zitierung von Informationen kontinuierlich verbessern.