
llms.txt常被描述为“提交给所有AI的平台入口”,但目前它不是所有答案系统共同采用的强制标准,也不保证抓取、引用或推荐。Google公开指南明确表示,出现在其生成式搜索功能中不需要llms.txt或专用AI文本文件。因此企业可以把它作为机器可读的网站摘要实验,但不能用它替代HTML内容、Sitemap、robots和正常内链。
技术原理
一个合理的llms.txt只应概括公开网站身份、主要业务、重要内容入口和使用说明,并链接到现有规范URL。它不应包含后台数据、客户资料、API密钥或网页上不存在的事实。即使某些工具读取该文件,最终内容是否可信仍取决于目标页面。文件本身只是导航层,不能修复薄内容、错误Canonical或被阻止抓取的问题。
实施步骤
实施时先完成基础SEO和实体信息,再生成简洁文本:网站名称、业务说明、核心栏目、重点文档和Sitemap。链接使用绝对HTTPS地址,并从CMS已发布内容动态生成,排除noindex、草稿和重复页。为文件设置纯文本Content-Type,返回200并保持编码正确。更新站点结构时同步生成,但不要每次请求实时查询大量数据库。
验证与监测
监测服务器日志中是否有机器人访问llms.txt、访问后是否继续抓取目标页面,以及文件中的链接是否失效。评估时把它与不使用该文件的基础表现区分开,不能把流量变化直接归因于llms.txt。若平台官方政策更新,应调整定位并记录版本。
常见错误
常见错误是声称“安装后自动提交ChatGPT”、在文件中堆积整站正文、暴露不公开资料、列出Canonical冲突URL,或因为有llms.txt就忽略Sitemap。应在后台说明它的实验性和辅助性质,避免给运营人员错误预期。
落地建议
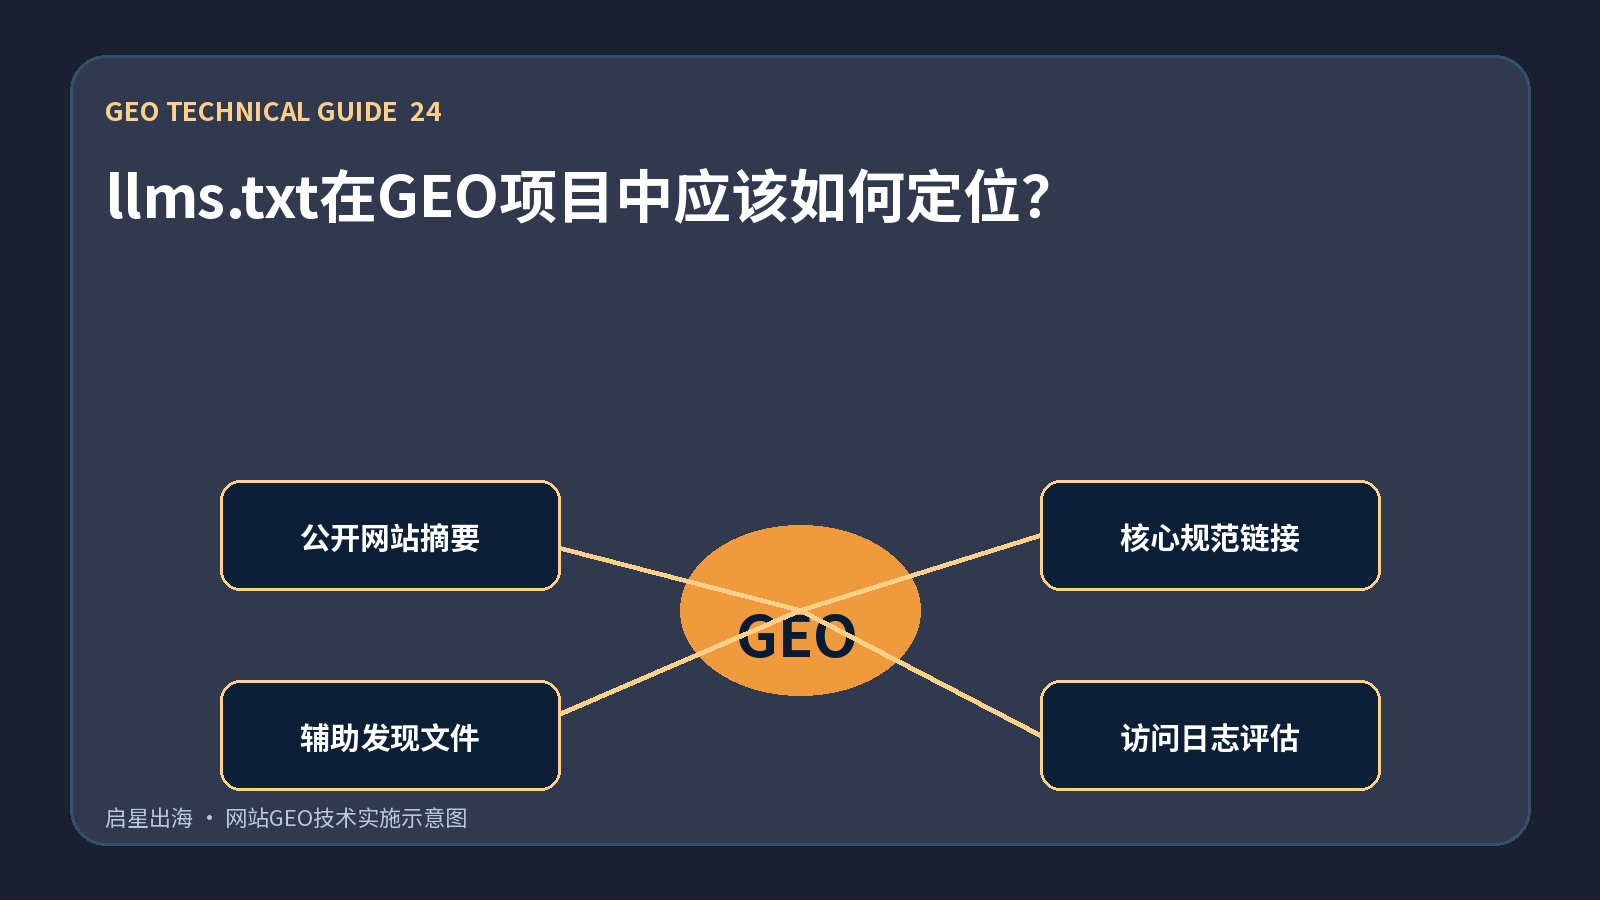
落地时应把“公开网站摘要、核心规范链接、辅助发现文件、访问日志评估”写入同一份发布检查表,明确内容负责人、技术负责人和复核日期。任何改动都要同时检查页面可见内容、HTML源代码、结构化数据、内部链接和站点地图,避免前台已经更新而机器读取层仍保留旧值。GEO不是一次性安装插件,也不能保证任何平台一定引用;它是一套持续提高信息可抓取、可验证、可归因和可引用程度的内容与技术工程。