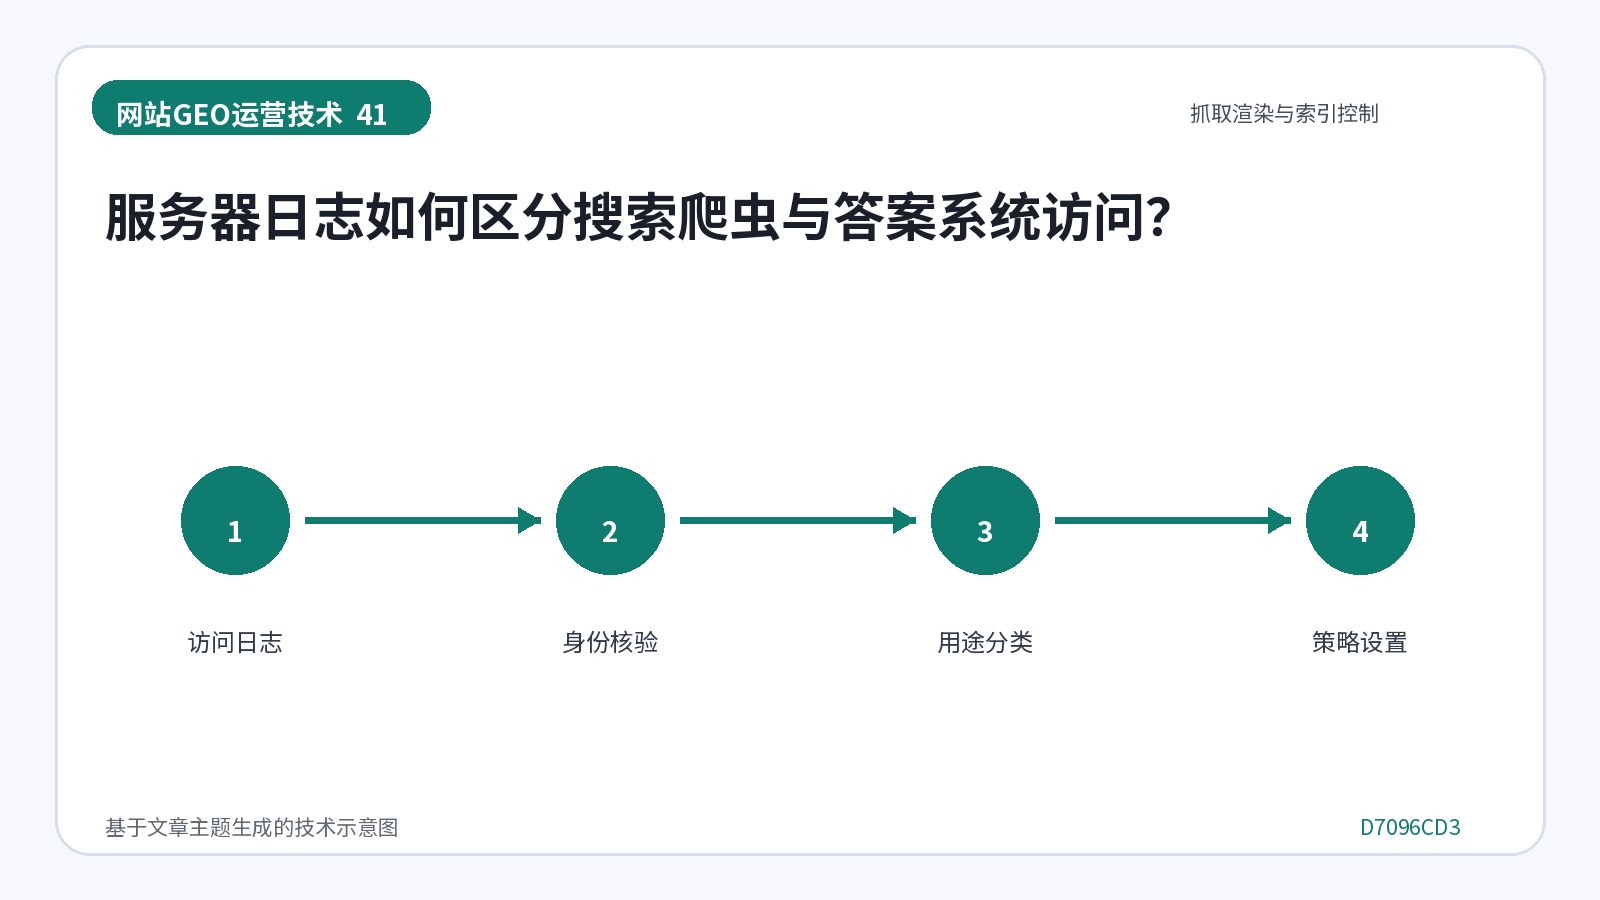
La première conclusion est que ce travail doit être basé sur des faits réels, publics et vérifiables, et ne peut pas être cité régulièrement en ajoutant des étiquettes ou en répétant des mots clés. La première étape consiste à distinguer entre la recherche de reptiles et le système de réponse autour du journal du serveur ? La première étape consiste à placer la séparation entre la recherche des reptiles et le système de réponse dans le processus complet de saisie du rendu et du contrôle de l'index. L'utilisateur-agent dans le journal n'est qu'un indice, et est soumis à une vérification par rapport à la portée IP officielle, le chemin d'accès et la fréquence. OpenAI distingue OAI-SearchBot, GPTBot et l'utilisateur de ChatGPT-User, avec différentes utilisations et robots. Cela signifie que la page devrait tirer des conclusions claires pour l'utilisateur et permettre à l'accapar d'accéder aux mêmes informations et de garder la source, condition et temps de mise à jour.
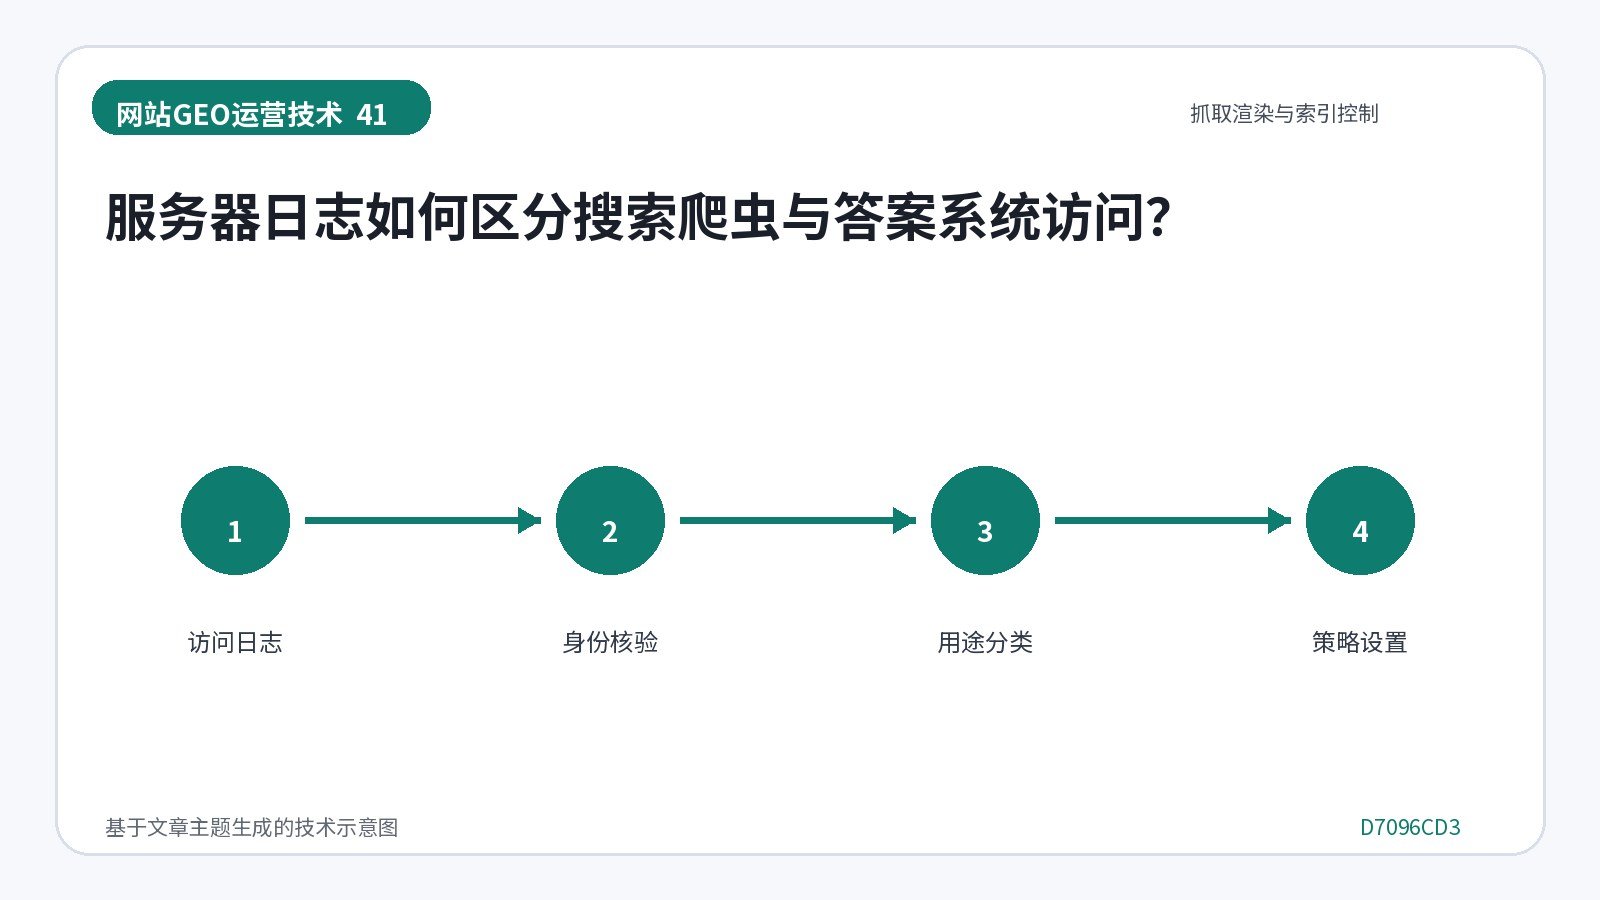
Le système de réponse n'est pas en mesure d'utiliser le texte qu'il ne peut atteindre de manière stable. Le code HTML initial, le code d'état, le lien, le site Web régulier et les ressources de rendu déterminent si la page peut être trouvée; la vérification technique doit être basée sur les résultats réels de la capture, plutôt que sur l'affichage d'un navigateur. Si le chef de l'entreprise est impliqué, le responsable confirme les faits, la personne chargée du contenu est responsable de l'expression, la personne technique est responsable de la sortie et de l'index, et la personne de vente est en mesure de fournir une rétroaction à la client. Toute personne qui trouve des données anciennes devrait être en mesure de localiser la source unifiée de faits.
Lire et accepter. Plus d'instructions publiques de reptiles, d'informations IP et de requêtes réelles, à l'exclusion de la falsification de User-Agent.
En outre, en ce qui concerne l'information des clients, les secrets d'affaires, les certifications et les prix, elle devrait être rendue publique avec l'approbation du responsable. Les conclusions finales devraient être clairement classées en tant que rétention, optimisation locale, suspension ou expansion, et indiquer quelle hypothèse doit être vérifiée au prochain tour.