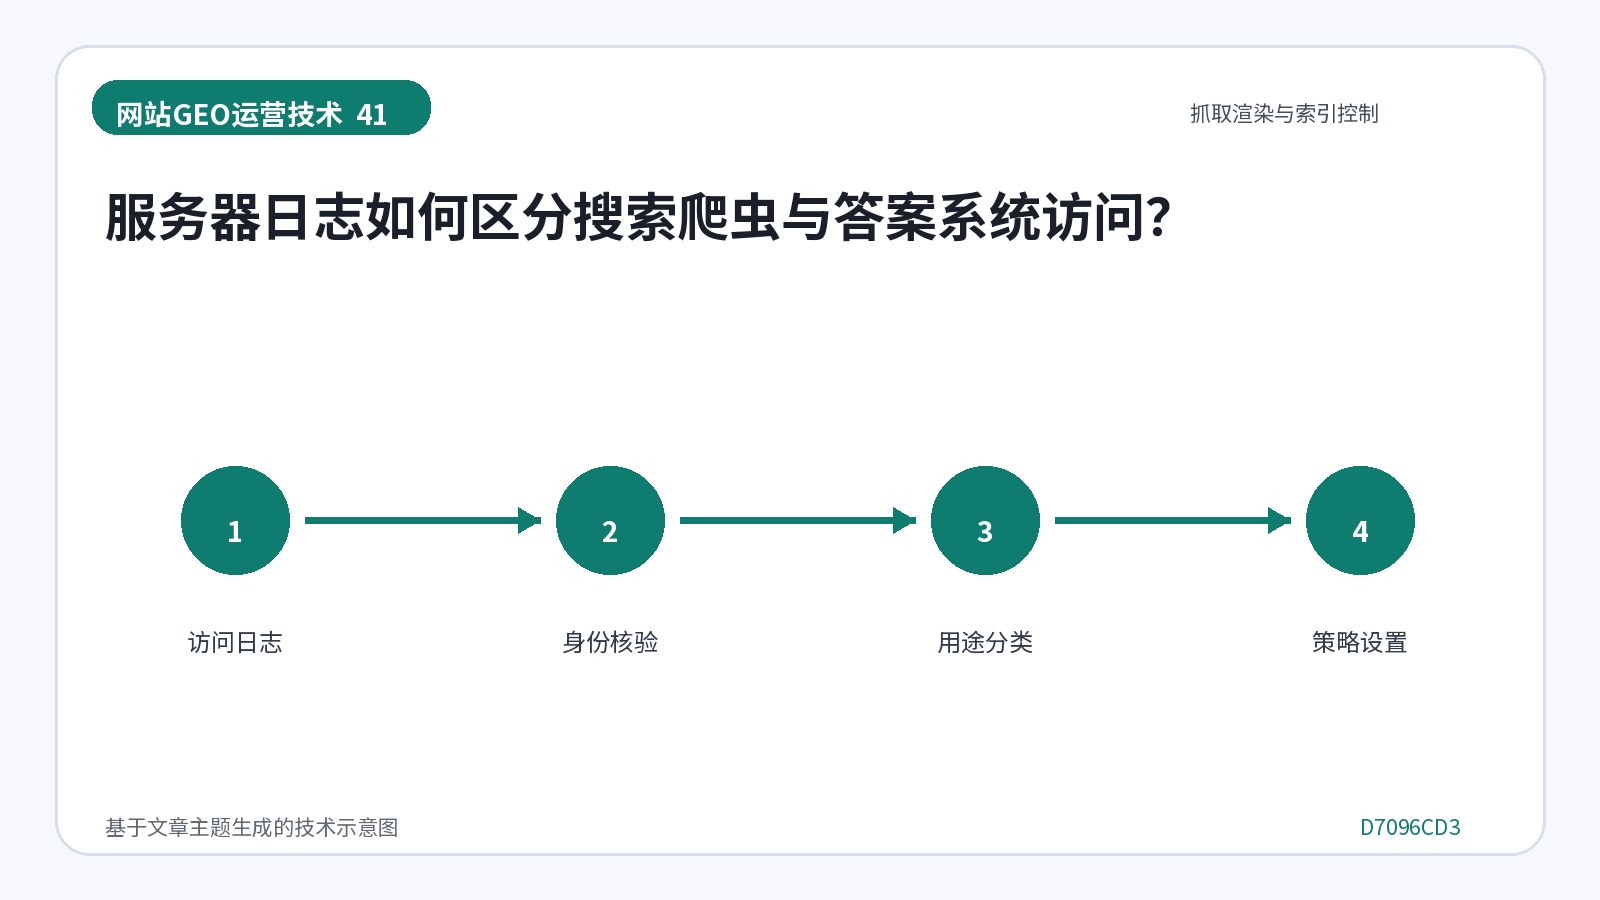
La primera conclusión es que este trabajo debe basarse en hechos reales, públicos y verificables, y no puede ser constantemente citado añadiendo etiquetas o repitiendo palabras clave. El primer paso es distinguir entre la búsqueda de reptiles y el sistema de respuesta alrededor del registro del servidor? El primer paso es colocar la separación entre la búsqueda de reptiles y el sistema de respuesta en el proceso completo de captura de renderizado y control de índice. El agente de usuario en el registro es sólo una pista, y está sujeto a verificación en relación con el alcance oficial de IP, la ruta de acceso y la frecuencia. OpenAI distingue OAI-SearchBot, GPTBot y el usuario-triggered ChatGPT-User, con diferentes usos y robots. Esto significa que la página debe sacar conclusiones claras para el usuario y permitir al agarrador acceder a la misma información y mantener el tiempo de fuente, condición y actualización.
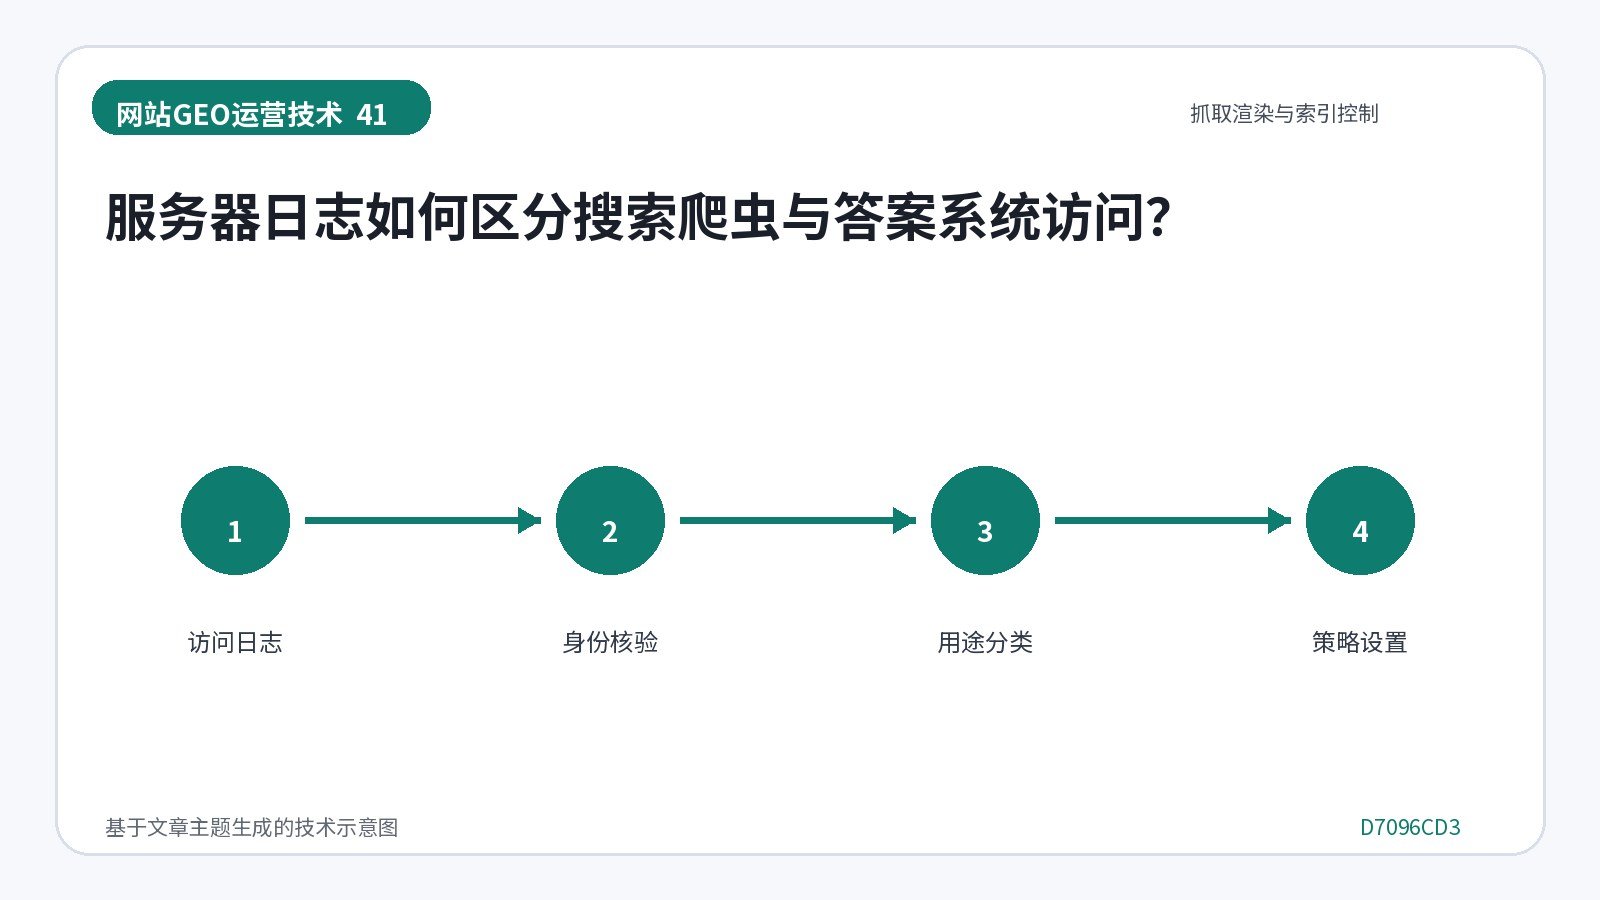
El sistema de respuesta no es capaz de utilizar el texto que no puede alcanzar de manera estable. El código HTML inicial, el código de estado, el enlace, el sitio web regular y los recursos de renderización determinan si se puede encontrar la página; el cheque técnico debe estar basado en resultados de captura reales, en lugar de sólo en una pantalla del navegador. Si el jefe del negocio está involucrado, la persona encargada confirma los hechos, la persona del contenido es responsable de la expresión, la persona técnica es responsable de la salida e índice, y el vendedor es capaz de proporcionar retroalimentación al cualquier persona que encuentre datos antiguos debe ser capaz de localizar la fuente unificada de hechos.
Leer y aceptar. Más instrucciones de reptil público, información IP y solicitudes reales, excluyendo la falsificación de Usuario-Agente.
Además, cuando se trata de información de clientes, secretos comerciales, certificaciones y precios, debe hacerse público con la aprobación del funcionario responsable. Las conclusiones finales deben clasificarse claramente como retención, optimización local, suspensión o expansión, y deben indicar qué hipótesis debe verificarse en la próxima ronda.