
En primer lugar, para concluir que las reglas coinciden con el reptil con el camino, y que el rango de comodín o directorio incorrecto puede proteger recursos importantes. Este es también el juicio más importante al tratar con “robots.txt cómo debe ser escrito para evitar rasguños por error”. Robots.txt controla el acceso, que no equivale a la eliminación fiable del sitio web del índice. Si la página de destino y la misión del usuario no deja claro que incluso si la herramienta da una puntuación bastante buena, la acción posterior es probable que se desvíe del rendimiento del negocio.
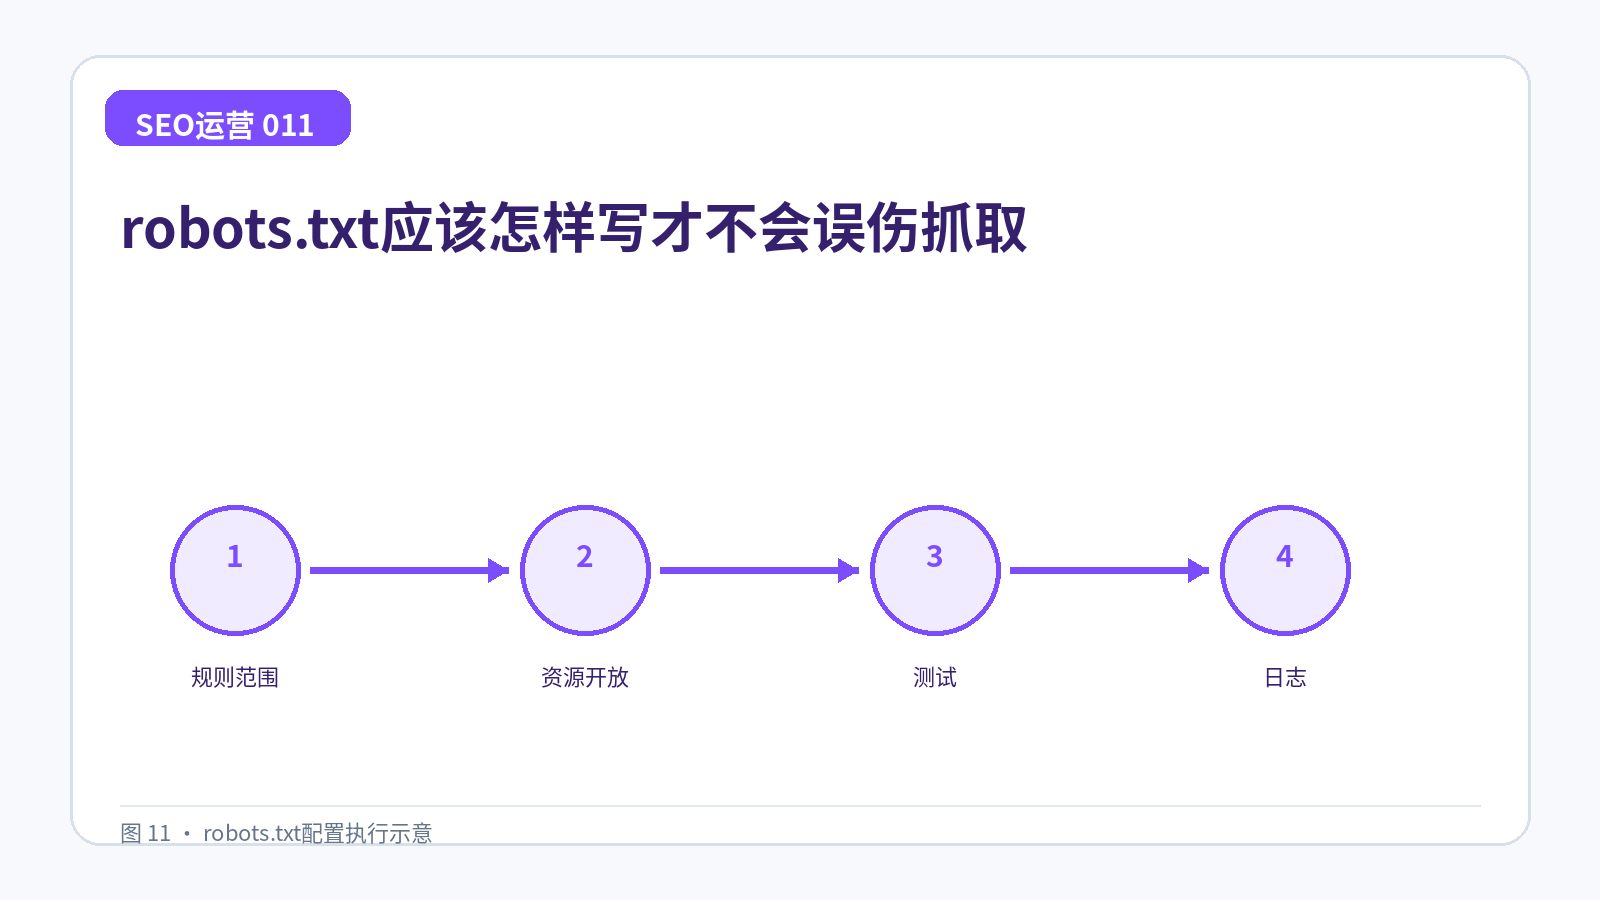
La implementación real puede comenzar con una pequeña muestra. En primer lugar, lista las páginas que deben abrirse, CSS y JavaScript, luego minimizar el backstage, búsqueda interna o parámetros ilimitados, y verificarlas en la herramienta de pruebas. En primer lugar, mantenga los datos originales y la versión web, y luego mantenga el alcance de los ajustes en la misma plantilla o tipo de URL, para que el equipo del proyecto pueda saber de dónde provienen las mejoras.
La recepción e inspección no puede permanecer en la página web. Revisar los registros del servidor y las URL confirma que Googlebot tiene acceso a recursos críticos y que está en línea para monitorear errores de captura. Se mantienen indicadores cuantitativos y de calidad: el primero describe la cobertura, el último indica si estas visitas resuelven el problema y si traen consigo un próximo paso eficaz.
Los agujeros más fáciles de pisar son: El tratamiento desigual de una página web registrada todavía puede permitir que el sitio aparezca en forma no sumaria, y noindex debe ser utilizado o eliminado para la eliminación del índice. Por lo tanto, las condiciones de aplicación, las personas responsables y las normas de cesación deben indicarse en la línea; en caso de anomalía, se debe restablecer la estabilidad y continuar el juicio sobre la base de registros, capturar el desempeño y los datos operacionales.
Este proceso no requiere un solo sitio re-completo. Seleccionar un conjunto representativo de páginas web sobre una base de prueba, observar un ciclo completo de captura y transformación, y luego consolidar reglas validadas en CMS, listas de verificación y unidades de flash mensuales, a menudo con efectos más fiables a largo plazo que ad hoc redadas.
A fin de evitar que la conclusión quede en el informe, se recomienda que las reglas y los registros se utilicen como elemento de aceptación en línea y que la anomalía sea juzgada por quién y cuánto tiempo se fijará. De esta manera, la nueva página seguirá el mismo estándar y la antigua página será descubierta a tiempo después de que el plantilla cambie.