
Erstens, um zu schließen, dass die Regeln das Reptil mit dem Pfad übereinstimmen und dass der falsche Platzhalter- oder Verzeichnisbereich wichtige Ressourcen abschirmen kann. Dies ist auch das wichtigste Urteil im Umgang mit „robots.txt, wie es geschrieben werden sollte, um versehentliches Kratzen zu vermeiden. Robots.txt kontrolliert den Zugriff, was nicht auf die zuverlässige Entfernung der Website aus dem Index hinausläuft. Wenn die Zielseite und die Mission des Benutzers nicht klarstellen, dass, selbst wenn das Tool eine ziemlich gute Punktzahl liefert, die nachfolgende Aktion wahrscheinlich von der Geschäftsleistung abweichen wird.
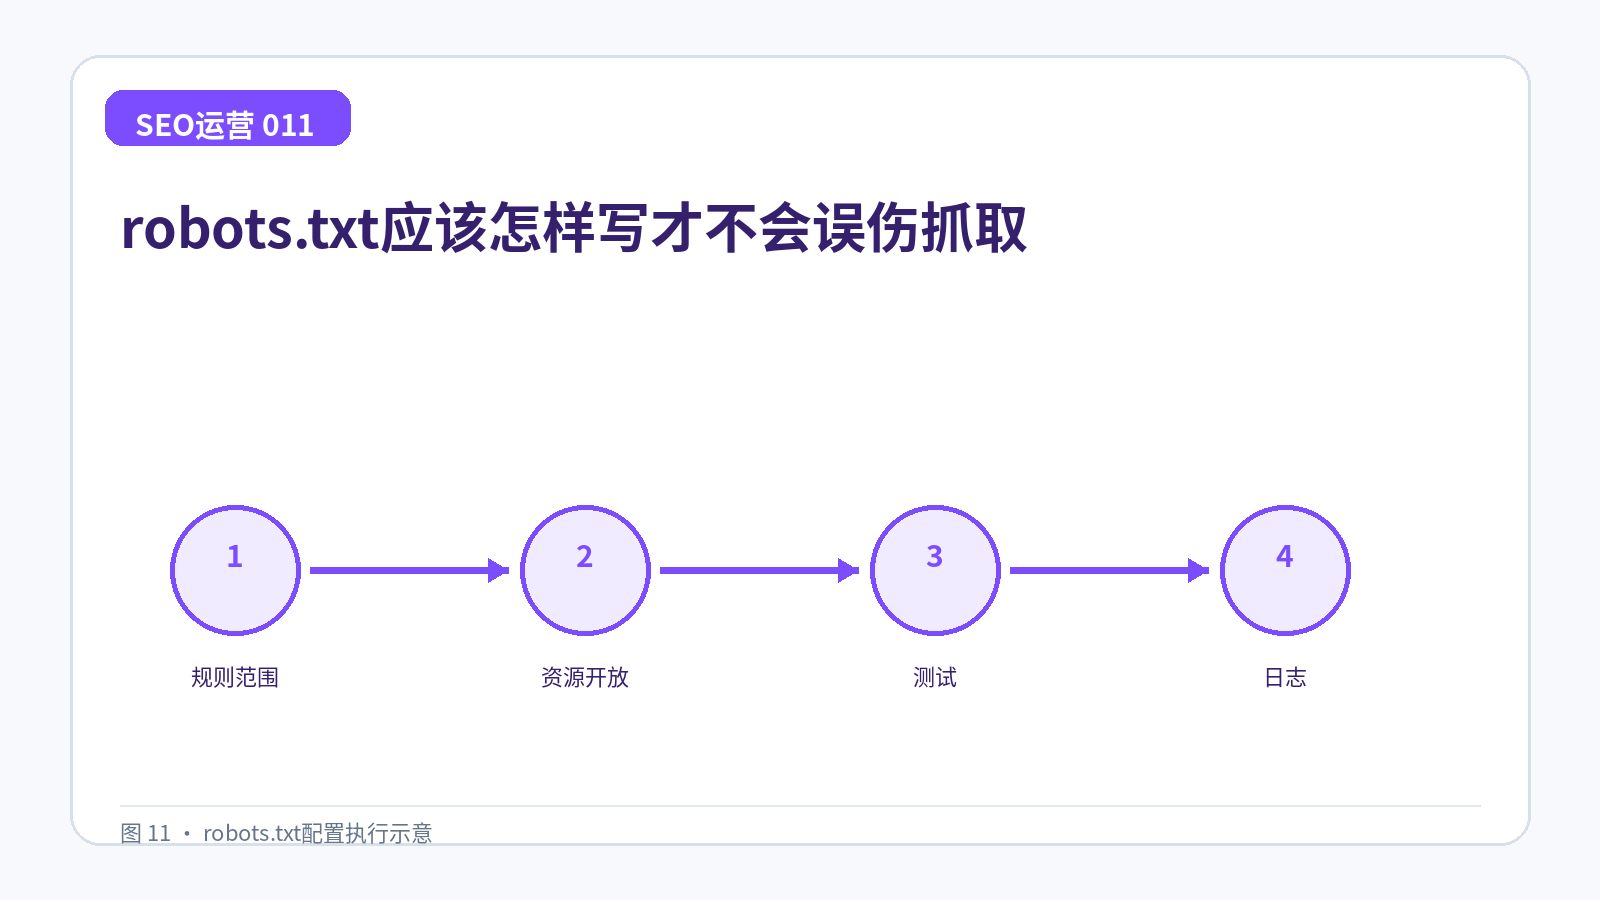
Die eigentliche Implementierung kann mit einem kleinen Sample beginnen. Zuerst die Seiten auflisten, die geöffnet werden müssen, CSS und JavaScript, dann Backstage, Inhouse Search oder unbegrenzte Parameter minimieren und im Testing Tool verifizieren. Behalten Sie zuerst die Originaldaten und die Webversion und dann den Umfang der Anpassungen in der gleichen Vorlage oder dem gleichen URL-Typ, damit das Projektteam wissen kann, woher die Verbesserungen stammen.
Die Überprüfung der Serverprotokolle und URLs bestätigt, dass der Googlebot Zugriff auf kritische Ressourcen hat und dass er online ist, um Erfassungsfehler zu überwachen. Quantitative und Qualitätsindikatoren werden beibehalten: Ersteres beschreibt die Abdeckung, letzteres zeigt an, ob diese Besuche das Problem lösen und ob sie einen effektiven nächsten Schritt bewirken.
Die einfachsten Boxen, auf die man treten kann, sind: Die Nichtbehandlung einer registrierten Webseite kann es immer noch ermöglichen, dass die Website in einer nicht zusammengefassten Form erscheint, und Noindex sollte für die Entfernung des Index verwendet oder gelöscht werden. Daher sollten die Anwendungsbedingungen, die verantwortlichen Personen und die Entwöhnungsregeln in der Zeile angegeben werden.Im Falle einer Anomalie sollte die Stabilität wiederhergestellt und die Beurteilung auf der Grundlage von Protokollen, Erfassungsleistung und Betriebsdaten fortgesetzt werden.
Dieser Vorgang erfordert keine einzige erneut abgeschlossene Site. Auswählen eines repräsentativen Satzes von Webseiten auf Probebasis, Beobachten eines vollständigen Erfassungs- und Transformationszyklus und anschließende Konsolidierung validierter Regeln in CMS, Checklisten und monatlichen Flash-Laufwerken, oft mit zuverlässigeren Langzeiteffekten als Ad-hoc Razzien.
Um zu verhindern, dass die Schlussfolgerung im Bericht verbleibt, wird empfohlen, die Regeln und Protokolle als aktuelles Annahmeelement zu verwenden und die Anomalie danach zu beurteilen, wer und wie lange sie behoben werden muss. Auf diese Weise folgt die neue Seite dem gleichen Standard und die alte Seite wird rechtzeitig nach dem Wechsel der Vorlage entdeckt.