
Il n'y a pas de réponse unique à la façon dont le navigateur Bread Crumb sert les utilisateurs et les moteurs de recherche en même temps. La Crumb indique où se trouve la page de contenu actuelle dans le site et fournit un lien stable vers le champ supérieur. La priorité est déterminée par l'arrêt de la saisie ou de l'index, puis par l'impact de la mission de l'utilisateur, et finalement par le point de référence de l'outil.
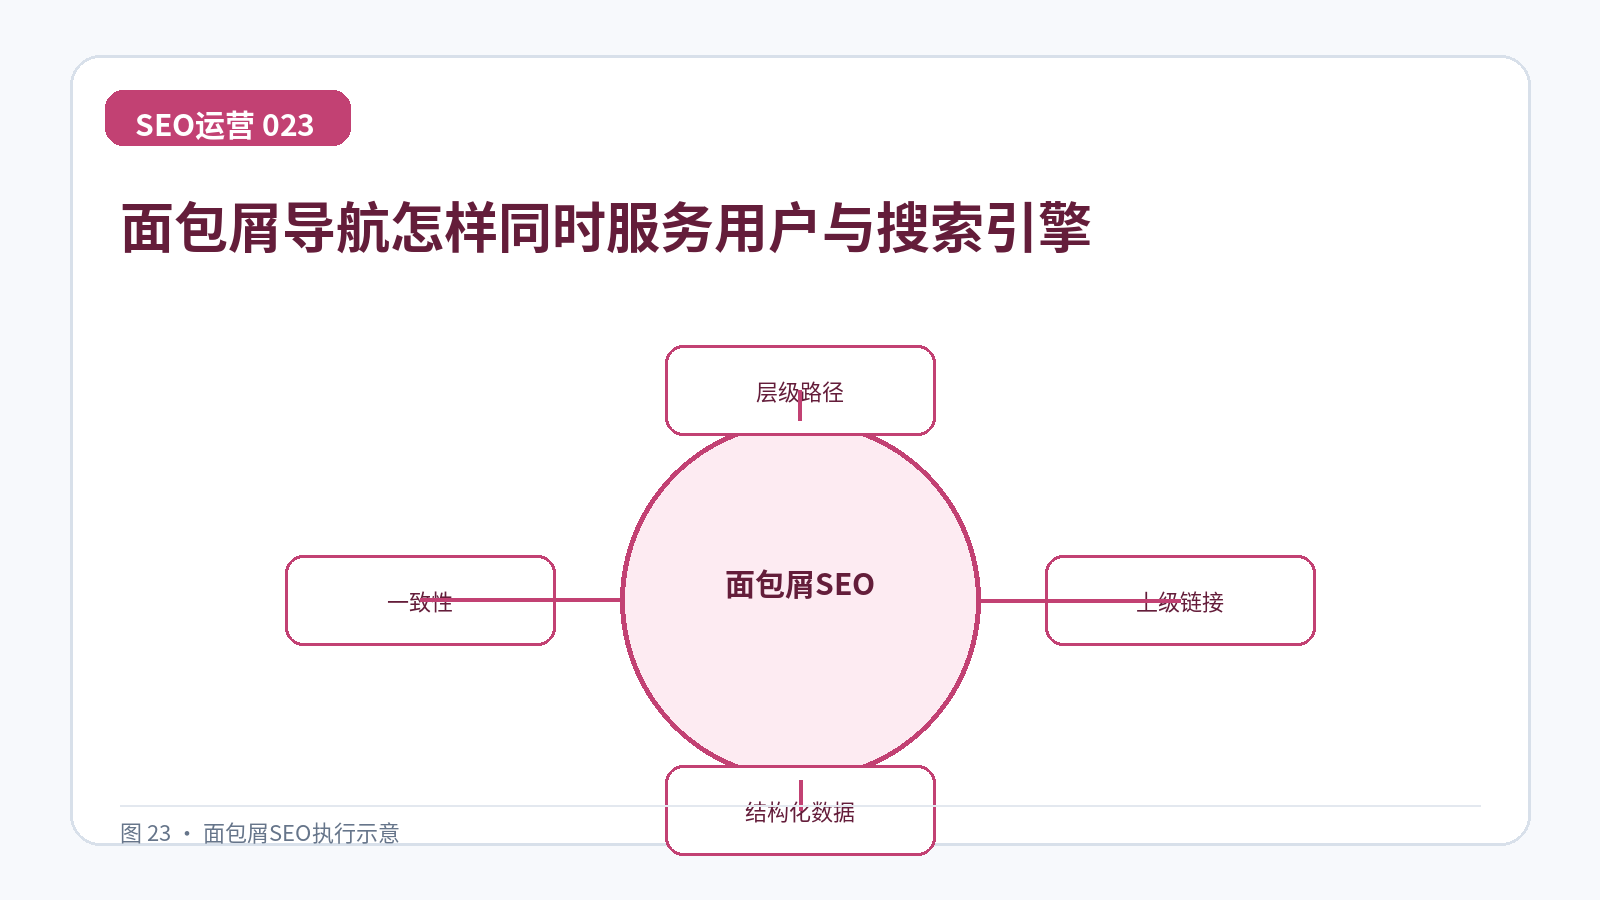
En ce qui concerne le mécanisme de travail de recherche, le chemin visible, le niveau URL et les données structurées devraient exprimer le même ensemble de relations logiques. Cela signifie que le contenu de la page de contenu, le signal HTML, le lien interne et la réponse du serveur doivent exprimer la même conclusion; n'importe lequel de ces niveaux est contradictoire et augmente le coût de la sélection du système et de l'erreur de l'opérateur.
Lorsque vous atterrissez, vous pouvez utiliser l'ordre dans lequel vous pouvez cliquer sur des miettes de pain sur le corps, utiliser le nom de page actuel à la fin et de la sortie Fil d'ArianeListe des données au niveau réel. Vérifiez l'URL réelle à chaque étape d'achèvement, et n'attendez pas que le lot entier soit libéré pour découvrir que la variable de modèle, le cache ou la version de langue n'est pas synchronisé.
Si les résultats ne sont pas améliorés, vérifier l'adéquation de l'échantillon et de la fenêtre de temps, puis juger si l'hypothèse n'est pas complète ou non. Ce qu'il faut éviter, c'est que les pastilles multidimensionnelles écrites avec de faux mots-clés peuvent induire les utilisateurs en erreur et que les données structurées ne doivent pas être incompatibles avec les pages de contenu. Le SEO ne quitte pas la scène avec une configuration à grande échelle et des compromis clairs sont plus importants que l'empilage.
Si l'opérateur dispose de ressources limitées, cette méthode est d'abord utilisée sur les pages de contenu qui peuvent générer des requêtes ou prendre des navigations importantes. Une fois que le lien parent et les données structurées peuvent être transmis régulièrement, il peut être étendu au catalogue à faible débit afin d'éviter la validation à grande échelle sans être traité.
Les données de recherche indiquent si la page de contenu a été trouvée, mais elles n'expliquent pas entièrement si la réponse est claire; Ceci peut être complété par une anomalie dans le service du client, le contenu de forme et le registre des ventes, qui optimisera le retour de la miette de pain aux besoins réels.