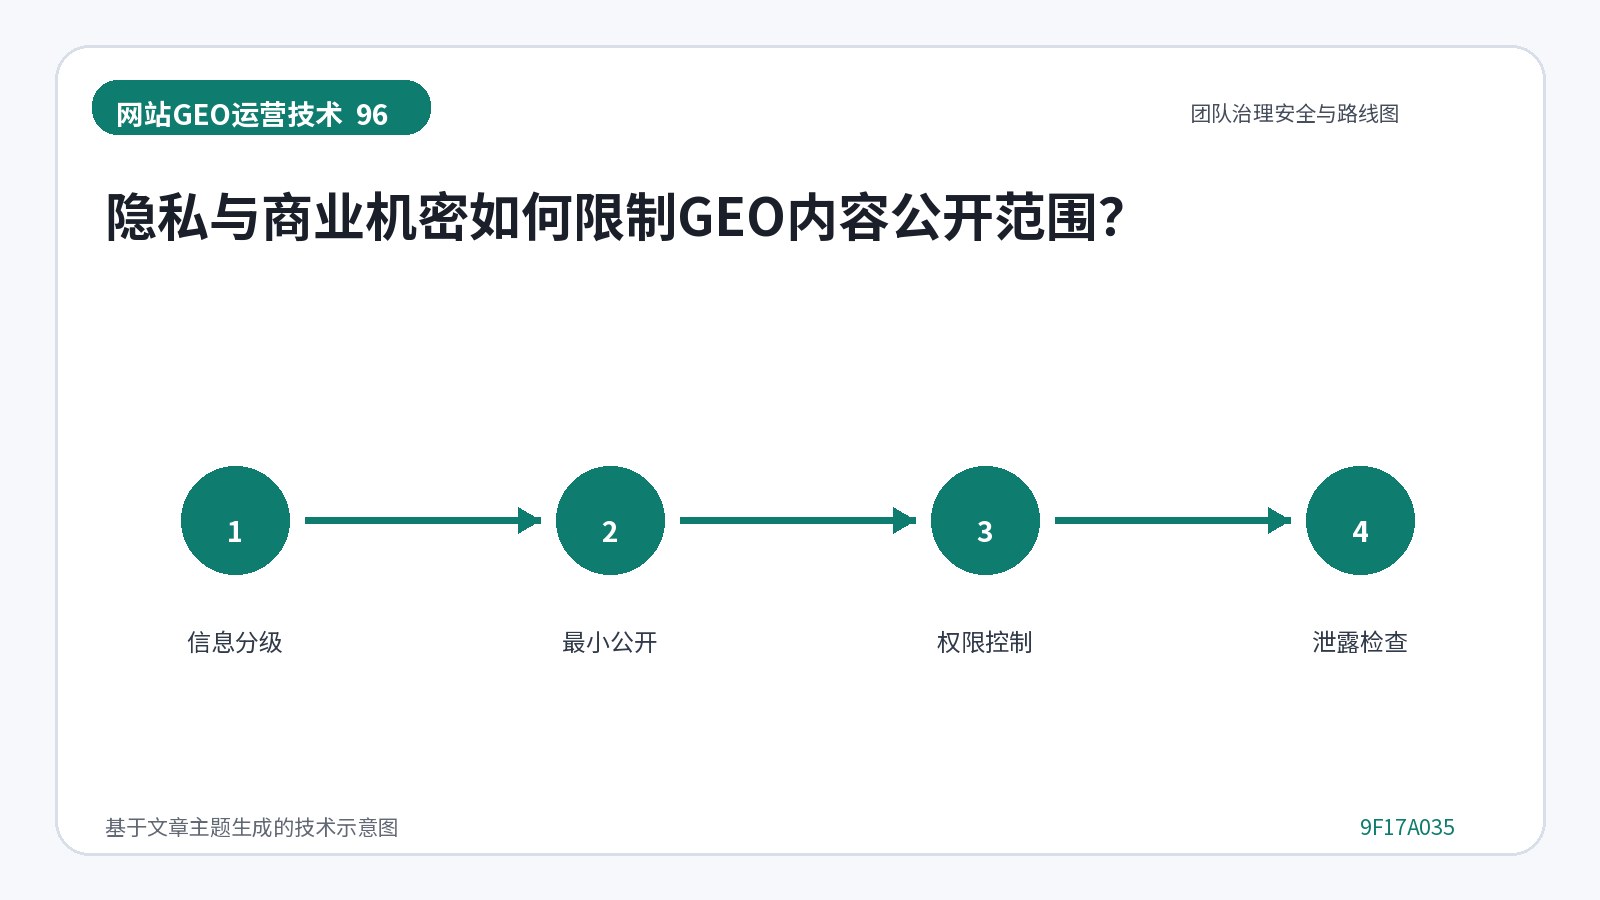
La dificultad con este trabajo no es la herramienta en sí, sino si el contenido, la tecnología y el calibre empresarial son los mismos; el uso de datos antiguos en cualquier nivel entraría en conflicto con la divulgación de los hechos. Alrededor de “Privacidad y secretos comerciales limitan el alcance público del contenido de GEO?”, el primer paso es poner la privacidad y los límites de confidencialidad empresarial de nuevo al proceso completo de “Seguridad de Gobernanza de Equipo y Mapa de Ruta”. La optimización de GEO no significa que toda la información se haga pública. Los dibujos de clientes, la información personal, los precios de los contratos y los procesos internos deben clasificarse según la autoridad; Sólo en la página pública se puede disponer de la información más pequeña necesaria para completar el fallo sobre adquisiciones. Esto significa que la página requiere tanto conclusiones claras para los usuarios como acceso a la misma información y retención de fuentes, condiciones y tiempo para actualizaciones.
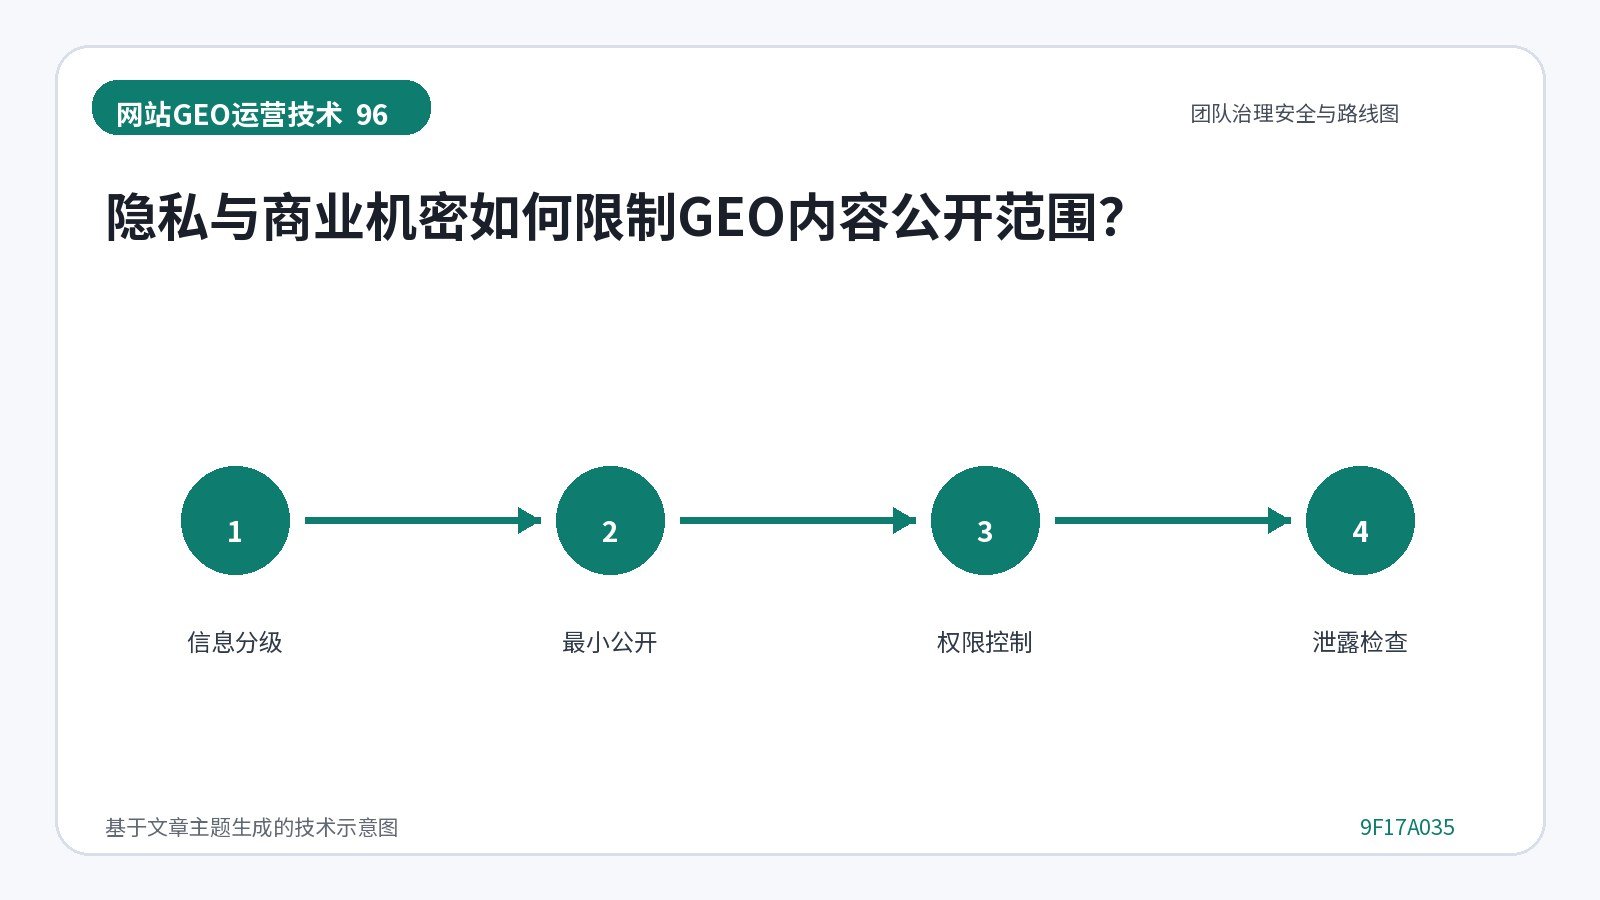
Cuando los recursos son limitados, se debe dar prioridad a abordar los aspectos que impiden la captura, crear un conflicto de hecho o una adquisición errónea. La optimización visual y la extensión pueden tener lugar más adelante, y no pueden asumir la misma prioridad que los problemas de alto riesgo.
El primer paso es establecer una clasificación abierta, restringida y confidencial, confirmando que la información subyacente no está en conflicto; entonces se realizan comprobaciones de desensibilización y autorización antes de la publicación; y finalmente se utilizan controles de acceso para proteger la información no pública.
La recepción e inspección no pueden limitarse a una respuesta de IA. Los archivos e índices públicos se escanean regularmente para comprobar si se filtra el contenido sensible. Es posible distinguir entre fluctuaciones ocasionales y cambios continuos mediante la grabación de preguntas de muestra, tiempo de prueba, área, inicio de sesión, referencia, enlaces y visitas posteriores. Es necesario evitar confiar en robots.txt para ocultar secretos que no son seguros, y la URL todavía puede ser accedido o filtrado. Además, cuando se trata de información de clientes, secretos comerciales, autenticación y precios, las conclusiones finales deben clasificarse claramente como reservas, optimización local, suspensión o expansión, y sólo se debe verificar una suposición en la próxima ronda.